
PDF vers JSON
Un PDF entre. Du JSON sort.
Importez un PDF, natif ou scanné, transférez-le par e-mail ou envoyez-le à l’API. Parsevix lit chaque page et renvoie les données en JSON, dans vos propres champs ou nommées avec les libellés du document. Essayez avec les vrais documents de la démo.
- PDF texte et PDF scannés, sans distinction
- Jusqu’à 30 pages par fichier
- Vos propres champs, ou aucun schéma
Sans carte bancaire · 20 pages offertes chaque mois
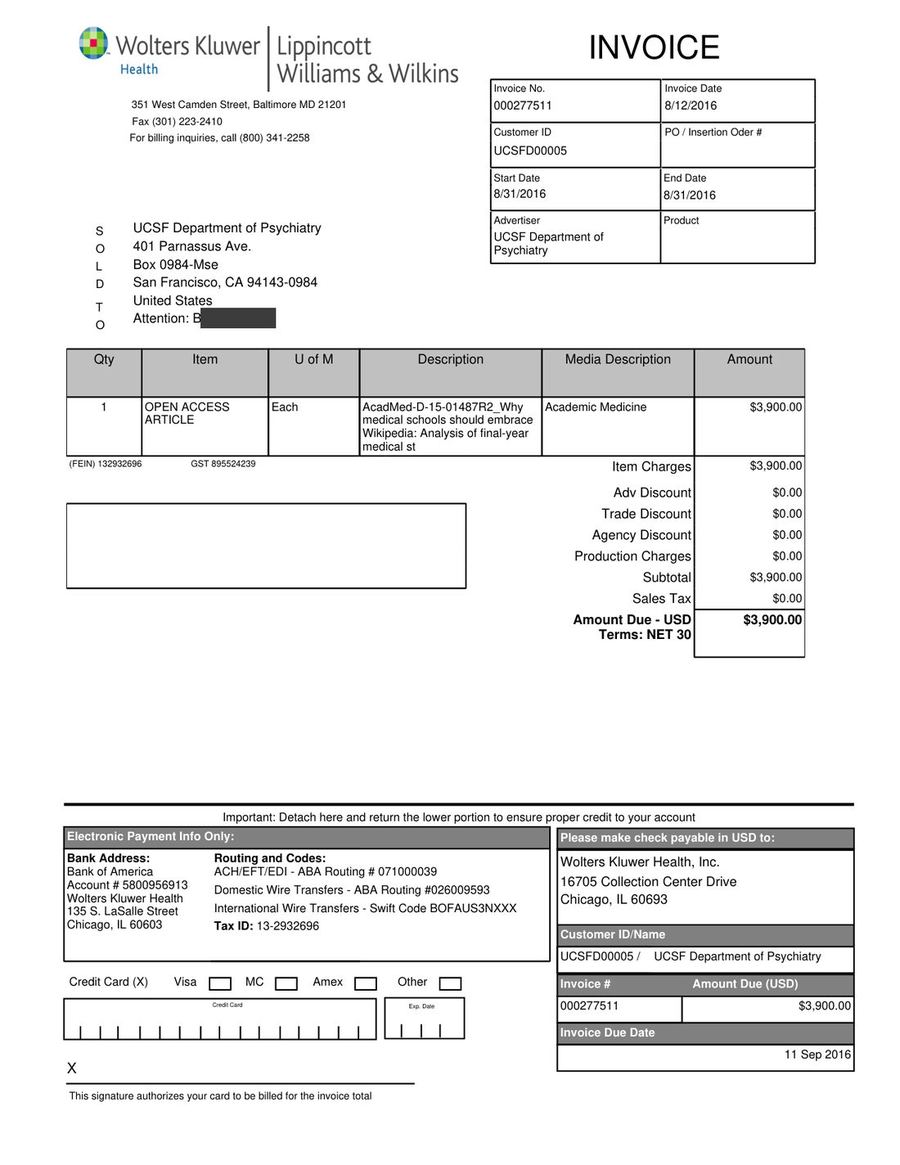
Nous avons noirci les noms des particuliers. Rien n’est importé : la démo rejoue le résultat enregistré.
Deux façons de façonner le JSON
Votre schéma, ou aucun.
Le même document peut revenir avec les champs que vous avez définis, ou avec ceux qu’il contient. Choisissez pour chaque import, chaque adresse e-mail ou chaque appel d’API.
Avec une catégorie
Nommez une fois les champs dont vous avez besoin, ou partez d’une catégorie intégrée comme Invoice ou Contract. Chaque document de ce type revient sous la même forme, avec des dates ISO et des nombres simples.
- invoice_number
- invoice_date
- seller_info
- line_items
- total_due
- currency
Des catégories intégrées pour les factures, les tickets, les contrats, les pièces d’identité et plus encore ; les vôtres pour tout le reste.
Sans schéma
Envoyez le document sans catégorie et obtenez chaque champ que Parsevix trouve, nommé avec les libellés du document et dans sa langue, les valeurs telles qu’imprimées. La démo ci-dessus fonctionne ainsi.
Le début du résultat du ticket du magasin de chaussures, tel qu’il est revenu.
Comment un PDF est lu
Chaque page, chaque ligne.
Les PDF viennent de logiciels comptables, de scanners et de pièces jointes d’e-mails, avec ou sans couche texte. Parsevix les traite tous de la même façon.
Chaque page lue comme une image
Parsevix rend chaque page en image et la lit par OCR, même quand le PDF a une couche texte, si bien que le texte des tampons, des pages scannées et des images intégrées est lu aussi. La langue est détectée sur chaque page, et les lignes partent vers l’extraction dans l’ordre de lecture.
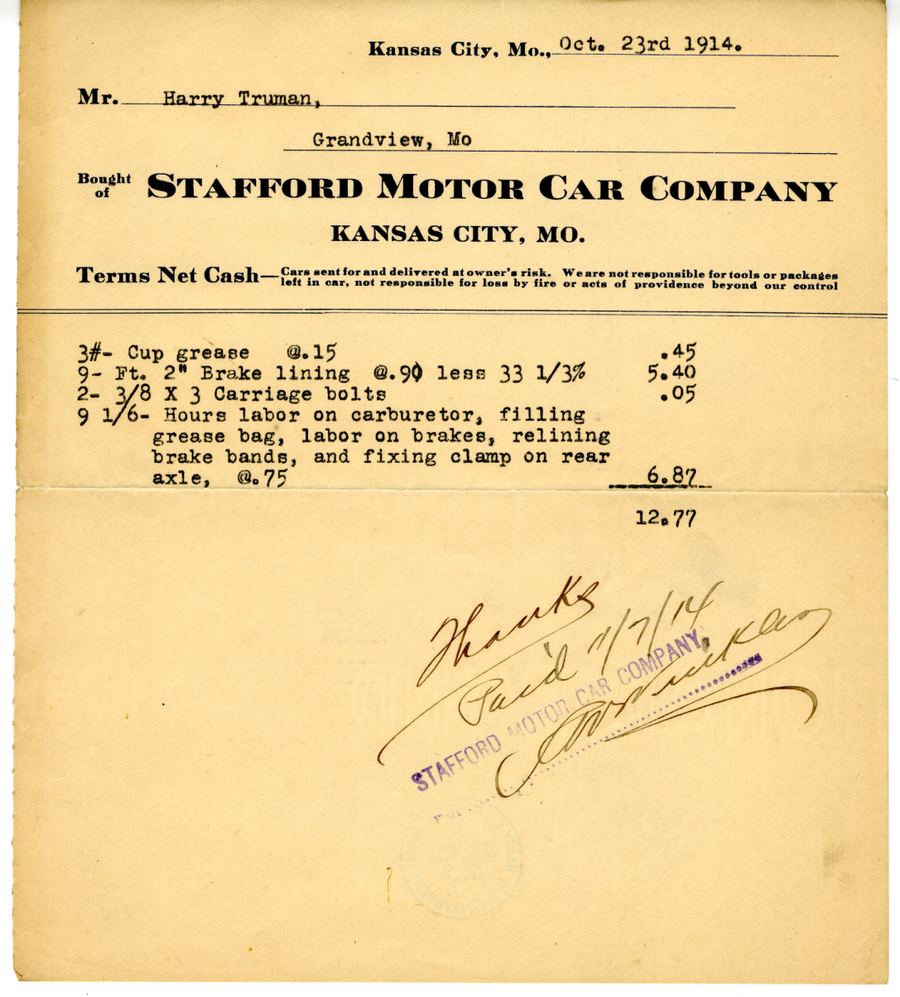
- 02
Les tableaux deviennent des listes
Les lignes d’un tableau reviennent sous forme de liste, un élément par ligne, y compris quand le tableau continue sur la page suivante.
- 03
Les longs documents d’un seul tenant
Un PDF de 30 pages au maximum est lu et extrait comme un seul document : totaux et lignes de détail de pages différentes se retrouvent dans un seul résultat.
- 04
De nombreuses langues et écritures
Écritures latine, cyrillique, grecque, arabe, chinoise, japonaise et coréenne, entre autres ; la langue est détectée sur chaque page.
- 05
Données personnelles masquées
Les noms, adresses et numéros sont masqués automatiquement avant que le moindre texte parte vers le modèle d’IA, puis remis dans votre résultat. La détection repère la plupart des données personnelles, mais pas forcément chacune.
- 06
Chaque valeur reliée à sa page
Chaque valeur est reliée à l’endroit de la page d’où elle provient. Cliquez dessus dans le tableau de bord pour voir où elle était imprimée.
- 07
Des PDF depuis votre boîte mail
Transférez les e-mails avec des PDF en pièce jointe à l’adresse de votre projet : chaque pièce jointe devient un document.
Comment les PDF arrivent
Importez-les, transférez-les ou envoyez-les depuis votre système.
Tableau de bord
Déposez des PDF dans le tableau de bord, un par un ou plusieurs à la fois. Vérifiez chaque résultat à côté de ses pages, puis approuvez-le.
Adresse e-mail
Forfaits payantsChaque projet a sa propre adresse. Transférez-y des PDF : chaque pièce jointe devient un document.
API
Envoyez des PDF depuis votre propre système et recevez le JSON dans la même réponse, ou recevez les résultats par webhook signé ou via Zapier.
Requête
curl https://parsevix.com/api/v1/extract-auto \
  -H "X-API-Key: $PARSEVIX_API_KEY" \
  -F file=@invoice.pdf
La requête reste ouverte jusqu’à ce que le document soit lu et répond avec le JSON.
- POST /documentsImporter sans attendre ; le résultat arrive par webhook ou callback.
- POST /extract-autoSans catégorie : chaque champ que Parsevix trouve, nommé comme dans le document.
- POST /classifySeulement la catégorie du document, pour 1 crédit.
Réponse · abrégée
Sécurité et conformité
- Données personnelles masquéesautomatiquement, avant l’étape d’IA
- Chiffréen transit et au repos
- Aucun entraînement d’IAsur vos documents
- Fichiers API supprimésaprès traitement
À la page, pas à la fonctionnalité.
Chaque forfait lit, classe et masque les documents de la même façon. Le choix de la catégorie est inclus, et un document en échec ne coûte rien.
Voir les tarifs- crédit par page
- 1
- pages offertes chaque mois
- 20
- par mois pour 500 pages
- $39
FAQ PDF vers JSON
PDF vers JSON,
en questions.
Ce que l’on demande avant de convertir ses premiers PDF.
Encore une question ?
Écrivez-nous. Chaque message est lu par une vraie personne.
Jusqu’à 10 Mo et 30 pages par fichier. Un PDF plus long doit être découpé en plusieurs fichiers, et chaque partie revient comme un résultat distinct.
Oui. Chaque page est lue comme une image : un scan sans couche texte est donc lu de la même façon qu’un PDF sorti directement d’un logiciel comptable.
Un PDF qui demande un mot de passe à l’ouverture ne peut pas être lu et échoue avec une erreur explicite. Retirez le mot de passe, puis importez-le à nouveau.
Oui. Un fichier Word (DOCX) est d’abord converti en PDF, puis lu comme n’importe quel autre PDF.
Un crédit par page : un PDF de dix pages en coûte dix. Le choix de la catégorie est inclus, et si un document échoue, ses crédits vous sont rendus.
Les PDF importés dans le tableau de bord ou envoyés par e-mail restent dans votre projet jusqu’à ce que vous les supprimiez. Les fichiers envoyés via l’API sont supprimés après traitement, sauf si vous activez leur conservation pour le projet. Vos documents ne servent jamais à entraîner une IA.
Cas d’usage associés
Les documents qui accompagnent celui-ci.
Extraction de factures
Fournisseur, totaux, TVA et chaque ligne de détail des factures, quelle que soit leur mise en page.
Extraction de données de contrats
Parties, dates, montant et principales clauses d’un contrat.
Conversion de relevés bancaires
Compte, soldes et chaque opération des relevés en PDF.