
API OCR
Un fichier entre. Du JSON sort.
Envoyez un PDF, un fichier Word ou une image à un seul endpoint. Parsevix lit chaque page par OCR, masque les données personnelles et renvoie les données du document en JSON, dans vos propres champs ou nommées avec les libellés du document. Essayez avec les vrais documents de la démo.
- OCR intégré, scans et photos compris
- Du JSON structuré, pas du texte brut
- Synchrone, ou par webhook
Sans carte bancaire · 20 pages offertes chaque mois
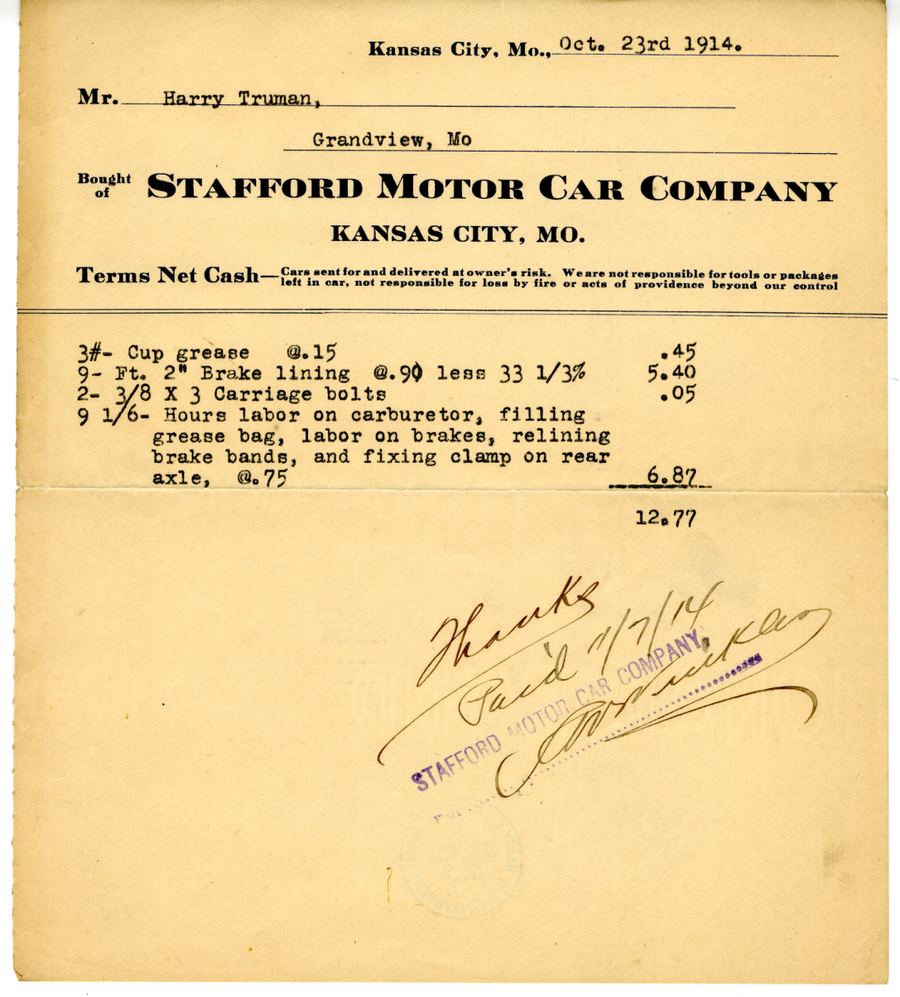
Rien n’est importé : la démo rejoue le résultat enregistré.
La requête et la réponse
Un appel, tout dans la réponse.
Tableau de bord
Essayez d’abord des documents dans le tableau de bord : chaque résultat s’affiche à côté de sa page, chaque valeur repérée là où elle a été lue.
Adresse e-mail
Forfaits payantsChaque projet a sa propre adresse. Les documents qui y sont transférés sont traités comme tout autre import, et leurs résultats peuvent vous parvenir par webhook.
API
Envoyez le fichier avec votre clé API. La réponse est du JSON : les champs du document, sa langue et son nombre de pages.
Requête
curl https://parsevix.com/api/v1/extract-auto \
  -H "X-API-Key: $PARSEVIX_API_KEY" \
  -F file=@invoice.pdf
La requête reste ouverte jusqu’à ce que le document soit lu et répond avec le JSON.
- POST /documentsImporter sans attendre ; le résultat arrive par webhook ou callback.
- POST /extract-autoSans catégorie : chaque champ que Parsevix trouve, nommé comme dans le document.
- POST /classifySeulement la catégorie du document, pour 1 crédit.
Réponse · abrégée
Conçu pour les développeurs
OCR et extraction en un appel.
Une requête par document, une réponse JSON. Voici ce que l’API vous donne.
OCR intégré
Pas besoin de votre propre moteur OCR. Parsevix rend chaque page et la lit, scans et photos de téléphone compris, redresse les pages couchées ou à l’envers et détecte la langue sur chaque page. Les champs sont extraits de ce qui a été lu, et vous recevez du JSON.
- 02
Les écritures lues
Latin, chinois et japonais, et avec des modèles dédiés cyrillique, grec, arabe, coréen, devanagari, thaï, tamoul et télougou. L’hébreu, l’arménien et le géorgien ne sont pas encore lus.
- 03
Synchrone par défaut
POST /api/v1/extract attend que le document soit lu et répond avec le résultat. Jusqu’à 5 requêtes ouvertes par clé et 30 pages par fichier.
- 04
Ou asynchrone
POST /api/v1/documents répond aussitôt ; le résultat suit par webhook signé, par une URL de callback ou via Zapier.
- 05
Limites selon le forfait
De 10 requêtes par minute et par clé sur le forfait gratuit à 300 sur Business. Tous les forfaits lisent les documents de la même façon.
- 06
Une seule forme d’erreur
Chaque erreur est { "error": { "code", "message" } } avec un code stable à points, pour que votre code distingue un quota épuisé d’un fichier illisible.
- 07
Fichiers supprimés après traitement
Les fichiers envoyés via l’API sont supprimés dès que le résultat est parti, sauf si vous activez leur conservation pour le projet.
Sécurité et conformité
- Données personnelles masquéesautomatiquement, avant l’étape d’IA
- Chiffréen transit et au repos
- Aucun entraînement d’IAsur vos documents
- Fichiers API supprimésaprès traitement
À la page, pas à la fonctionnalité.
Chaque forfait lit, classe et masque les documents de la même façon. Le choix de la catégorie est inclus, et un document en échec ne coûte rien.
Voir les tarifs- crédit par page
- 1
- pages offertes chaque mois
- 20
- par mois pour 500 pages
- $39
FAQ API OCR
L’API OCR,
en questions.
Ce que les développeurs demandent avant leur première requête.
Encore une question ?
Écrivez-nous. Chaque message est lu par une vraie personne.
Non. L’OCR fait partie de chaque requête : Parsevix lit les pages lui-même et répond avec les données du document en JSON, pour un crédit par page. Il n’y a pas d’endpoint séparé pour le texte brut.
Des documents en écriture latine, cyrillique, grecque, arabe, chinoise, japonaise et coréenne, entre autres ; la langue est détectée sur chaque page. L’hébreu, l’arménien, le géorgien, le bengali, le gujarati et le pendjabi ne sont pas encore lus.
Le texte imprimé ou dactylographié donne les meilleurs résultats. L’écriture manuscrite est lue là où elle est nette ; ce qui ne peut pas être lu reste vide au lieu d’être deviné.
Une requête synchrone attend jusqu’à 285 secondes, assez pour 30 pages. Au-delà, la réponse signale un délai dépassé ; pour les gros volumes, utilisez l’import asynchrone avec un webhook.
L’API est du HTTP simple, avec des imports multipart et des réponses JSON ; la documentation propose des exemples prêts à l’emploi pour cURL, Python et Node.js, et Zapier la connecte sans code.
Les fichiers envoyés via l’API sont supprimés après traitement, sauf si vous activez leur conservation pour le projet. Vos documents ne servent jamais à entraîner une IA.
Cas d’usage associés
Les documents qui accompagnent celui-ci.
Extraction de factures
Fournisseur, totaux, TVA et chaque ligne de détail des factures, quelle que soit leur mise en page.
OCR de tickets de caisse
Commerce, date, total et TVA des tickets papier ou photographiés.
OCR de pièces d’identité
Nom, numéro, dates et les deux lignes MRZ des passeports et cartes d’identité.