
PDF zu JSON
PDFs rein. JSON raus.
Lade ein PDF hoch, digital erstellt oder gescannt, leite es per E-Mail weiter oder schick es an die API. Parsevix liest jede Seite und liefert die Daten als JSON, in deinen eigenen Feldern oder benannt mit den Bezeichnungen des Dokuments. Probier es mit den echten Dokumenten in der Demo aus.
- Text-PDFs und gescannte PDFs gleichermaßen
- Bis 30 Seiten pro Datei
- Deine eigenen Felder, oder ganz ohne Schema
Keine Kreditkarte · 20 Gratis-Seiten jeden Monat
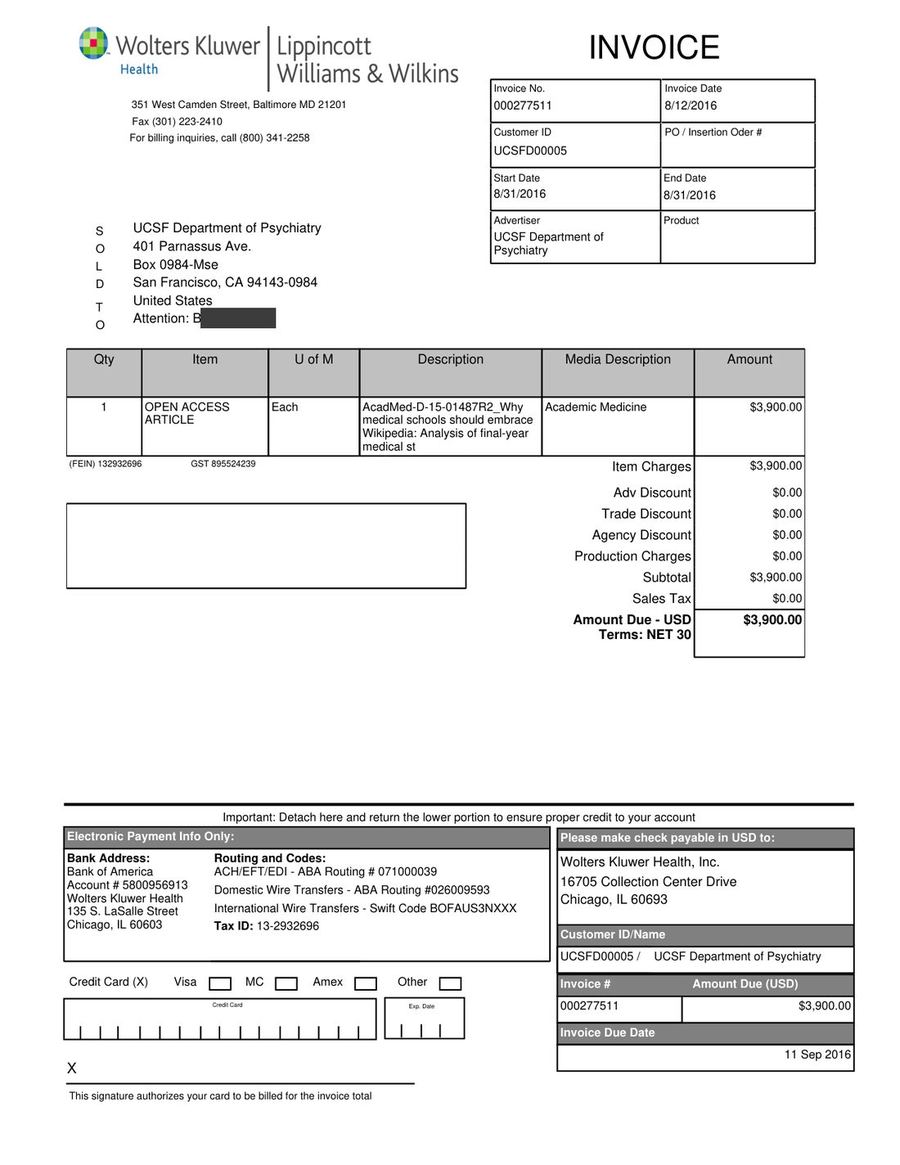
Die Namen von Privatpersonen haben wir geschwärzt. Es wird nichts hochgeladen: Die Demo spielt das gespeicherte Ergebnis ab.
Zwei Wege, das JSON zu formen
Dein Schema, oder ganz ohne.
Dasselbe Dokument kann in den Feldern zurückkommen, die du festgelegt hast, oder in den Feldern, die es selbst hat. Du wählst pro Upload, pro E-Mail-Adresse oder pro API-Aufruf.
Mit einer Kategorie
Benenne die Felder, die du brauchst, einmal, oder starte mit einer eingebauten Kategorie wie Invoice oder Contract. Jedes Dokument dieser Art kommt in derselben Form zurück, mit ISO-Datum und reinen Zahlen.
- invoice_number
- invoice_date
- seller_info
- line_items
- total_due
- currency
Eingebaute Kategorien für Rechnungen, Belege, Verträge, Ausweise und mehr; eigene für alles andere.
Ohne Schema
Schick das Dokument ohne Kategorie und bekomm jedes Feld, das Parsevix findet, benannt mit den Bezeichnungen des Dokuments und in seiner Sprache, die Werte so, wie sie gedruckt sind. Die Demo oben funktioniert so.
Der Anfang des Ergebnisses für den Kassenbon des Schuhgeschäfts, so wie es zurückkam.
So wird ein PDF gelesen
Jede Seite, jede Zeile.
PDFs kommen aus Buchhaltungssystemen, Scannern und E-Mail-Anhängen, mit und ohne Textebene. Parsevix behandelt sie alle gleich.
Jede Seite als Bild gelesen
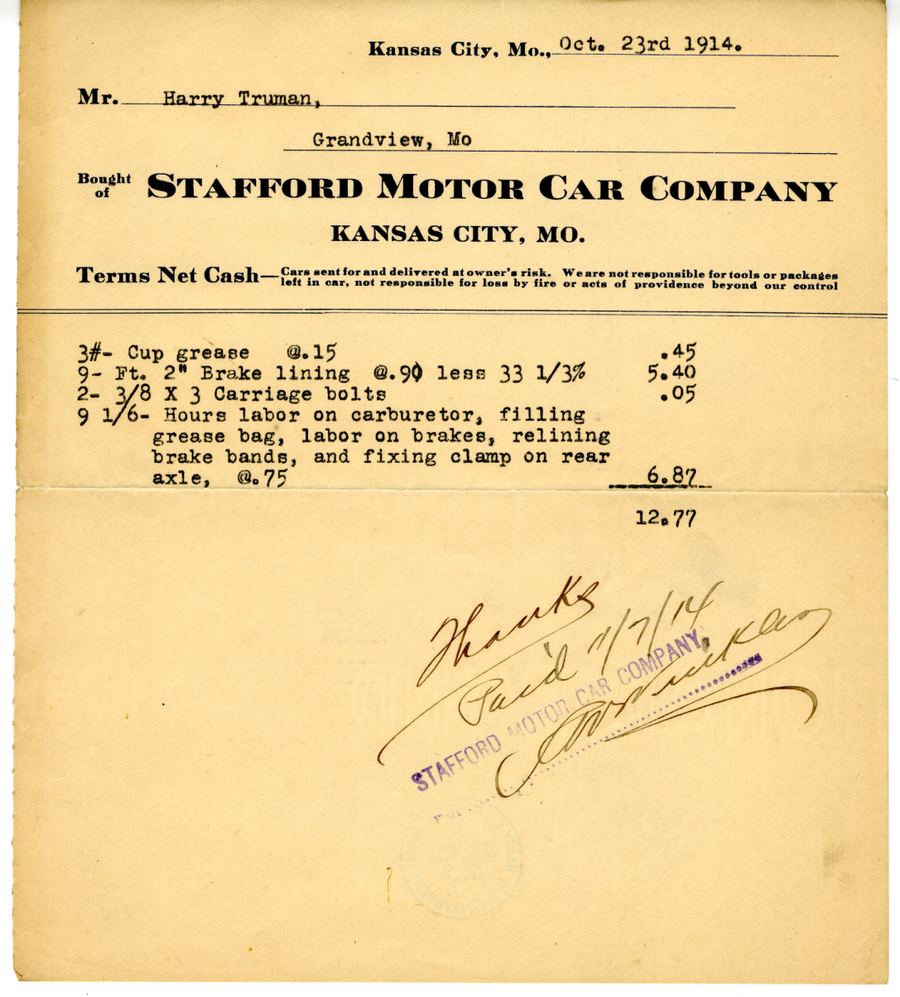
Parsevix rendert jede Seite und liest sie per OCR, auch wenn das PDF eine Textebene hat, sodass auch Text in Stempeln, gescannten Seiten und eingebetteten Bildern gelesen wird. Die Sprache wird auf jeder Seite erkannt, und die Zeilen gehen in Lesereihenfolge an die Extraktion.
- 02
Tabellen werden Listen
Die Zeilen einer Tabelle kommen als Liste zurück, ein Eintrag pro Zeile, auch wenn die Tabelle auf der nächsten Seite weitergeht.
- 03
Lange Dokumente in einem Durchgang
Ein PDF mit bis zu 30 Seiten wird als ein Dokument gelesen und ausgelesen, sodass Summen und Positionen von verschiedenen Seiten in einem Ergebnis landen.
- 04
Viele Sprachen und Schriften
Unter anderem lateinische, kyrillische, griechische, arabische, chinesische, japanische und koreanische Schrift; die Sprache wird auf jeder Seite erkannt.
- 05
Personenbezogene Daten maskiert
Namen, Adressen und Nummern werden automatisch maskiert, bevor Text an das KI-Modell geht, und in deinem Ergebnis wieder eingesetzt. Die Erkennung findet die meisten personenbezogenen Daten, aber nicht zwingend jede Angabe.
- 06
Jeder Wert mit seiner Seite verknüpft
Jeder Wert ist mit der Stelle auf der Seite verknüpft, von der er stammt. Klick ihn im Dashboard an, und du siehst, wo er gedruckt war.
- 07
PDFs aus deinem Postfach
Leite E-Mails mit PDF-Anhängen an die Adresse deines Projekts weiter, und jeder Anhang wird ein Dokument.
So kommen PDFs rein
Hochladen, weiterleiten oder aus deinem System senden.
Dashboard
Zieh PDFs ins Dashboard, einzeln oder viele auf einmal. Prüfe jedes Ergebnis neben seinen Seiten und gib es frei.
E-Mail-Adresse
Bezahlte PläneJedes Projekt bekommt eine eigene Adresse. Leite PDFs dorthin weiter, und jeder Anhang wird ein Dokument.
API
Schick PDFs aus deinem eigenen System und bekomm das JSON in derselben Antwort, oder erhalte Ergebnisse per signiertem Webhook oder über Zapier.
Anfrage
curl https://parsevix.com/api/v1/extract-auto \
  -H "X-API-Key: $PARSEVIX_API_KEY" \
  -F file=@invoice.pdf
Die Anfrage bleibt offen, bis das Dokument gelesen ist, und antwortet mit dem JSON.
- POST /documentsHochladen ohne Warten; das Ergebnis kommt per Webhook oder Callback.
- POST /extract-autoOhne Kategorie: jedes Feld, das Parsevix findet, benannt wie im Dokument.
- POST /classifyNur die Kategorie des Dokuments, für 1 Credit.
Antwort · gekürzt
Sicherheit & Compliance
- Personendaten maskiertautomatisch, vor dem KI-Schritt
- Verschlüsseltbei Übertragung und Speicherung
- Kein KI-Trainingmit deinen Dokumenten
- API-Dateien gelöschtnach der Verarbeitung
Pro Seite bezahlt, nicht pro Funktion.
Jeder Plan liest, sortiert und maskiert Dokumente gleich. Die Wahl der Kategorie ist inklusive, und ein fehlgeschlagenes Dokument kostet nichts.
Zu den Preisen- Credit pro Seite
- 1
- Gratis-Seiten jeden Monat
- 20
- im Monat für 500 Seiten
- $39
FAQ: PDF zu JSON
PDF zu JSON,
beantwortet.
Was Leute fragen, bevor sie ihre ersten PDFs umwandeln.
Bis 10 MB und 30 Seiten pro Datei. Ein längeres PDF muss auf mehrere Dateien aufgeteilt werden, und jeder Teil kommt als eigenes Ergebnis zurück.
Ja. Jede Seite wird als Bild gelesen, ein Scan ohne Textebene also genauso wie ein PDF direkt aus einem Buchhaltungssystem.
Ein PDF, das zum Öffnen ein Passwort braucht, kann nicht gelesen werden und schlägt mit einer klaren Fehlermeldung fehl. Entferne das Passwort und lade es dann erneut hoch.
Ja. Eine Word-Datei (DOCX) wird zuerst in ein PDF umgewandelt und dann wie jedes andere PDF gelesen.
Einen Credit pro Seite: Ein zehnseitiges PDF braucht zehn. Die Wahl der Kategorie ist inklusive, und schlägt ein Dokument fehl, bekommst du seine Credits zurück.
Im Dashboard hochgeladene oder per E-Mail geschickte PDFs bleiben in deinem Projekt, bis du sie löschst. Über die API gesendete Dateien werden nach der Verarbeitung gelöscht, außer du aktivierst das Aufbewahren für das Projekt. Deine Dokumente werden nie zum Trainieren von KI verwendet.
Verwandte Anwendungsfälle
Dokumente, die mit diesem Hand in Hand gehen.
Rechnungen auslesen
Lieferant, Summen, MwSt. und jede Position aus Rechnungen in jedem Layout.
Verträge auslesen
Parteien, Daten, Vertragswert und die wichtigsten Klauseln eines Vertrags.
Kontoauszüge auslesen
Konto, Salden und jeder Umsatz aus Kontoauszügen als PDF.