
PDF para JSON
Entram PDF. Sai JSON.
Carregue um PDF, digital ou digitalizado, reencaminhe-o por e-mail ou envie-o para a API. O Parsevix lê cada página e devolve os dados como JSON, nos seus próprios campos ou com o nome das etiquetas do próprio documento. Experimente com os documentos reais da demo.
- PDF de texto e PDF digitalizados, sem distinção
- Até 30 páginas por ficheiro
- Os seus próprios campos, ou nenhum esquema
Sem cartão de crédito · 20 páginas grátis todos os meses
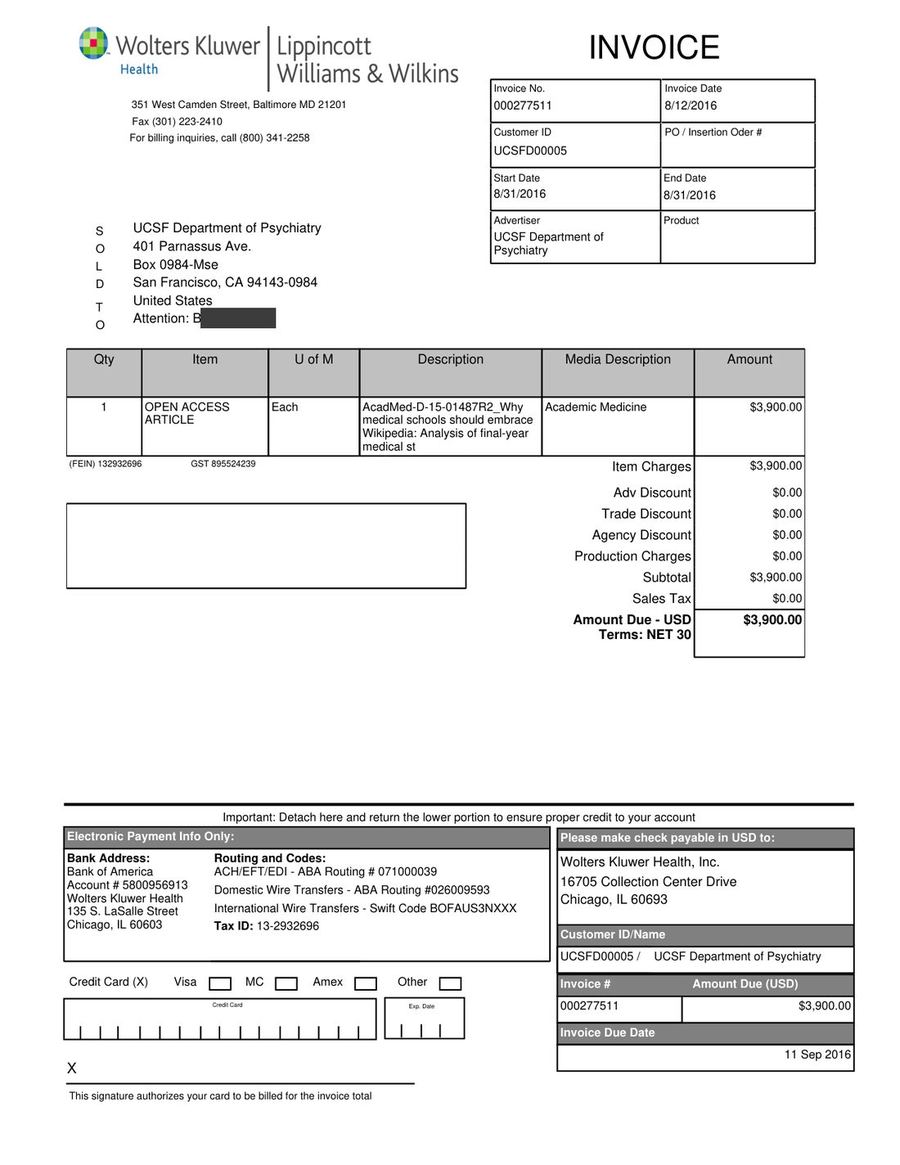
Ocultámos a negro os nomes de particulares. Nada é carregado: a demo reproduz o resultado guardado.
Duas formas de moldar o JSON
O seu esquema, ou nenhum.
O mesmo documento pode voltar com os campos que definiu ou com os campos que ele próprio tem. Escolha por carregamento, por endereço de e-mail ou por chamada à API.
Com uma categoria
Indique uma vez os campos de que precisa, ou comece com uma categoria integrada como Invoice ou Contract. Cada documento desse tipo volta com a mesma estrutura, com datas ISO e números simples.
- invoice_number
- invoice_date
- seller_info
- line_items
- total_due
- currency
Categorias integradas para faturas, talões, contratos, documentos de identificação e mais; as suas próprias para tudo o resto.
Sem esquema
Envie o documento sem categoria e obtenha todos os campos que o Parsevix encontrar, com o nome das etiquetas do próprio documento e no seu idioma, com os valores tal como estão impressos. A demo acima funciona assim.
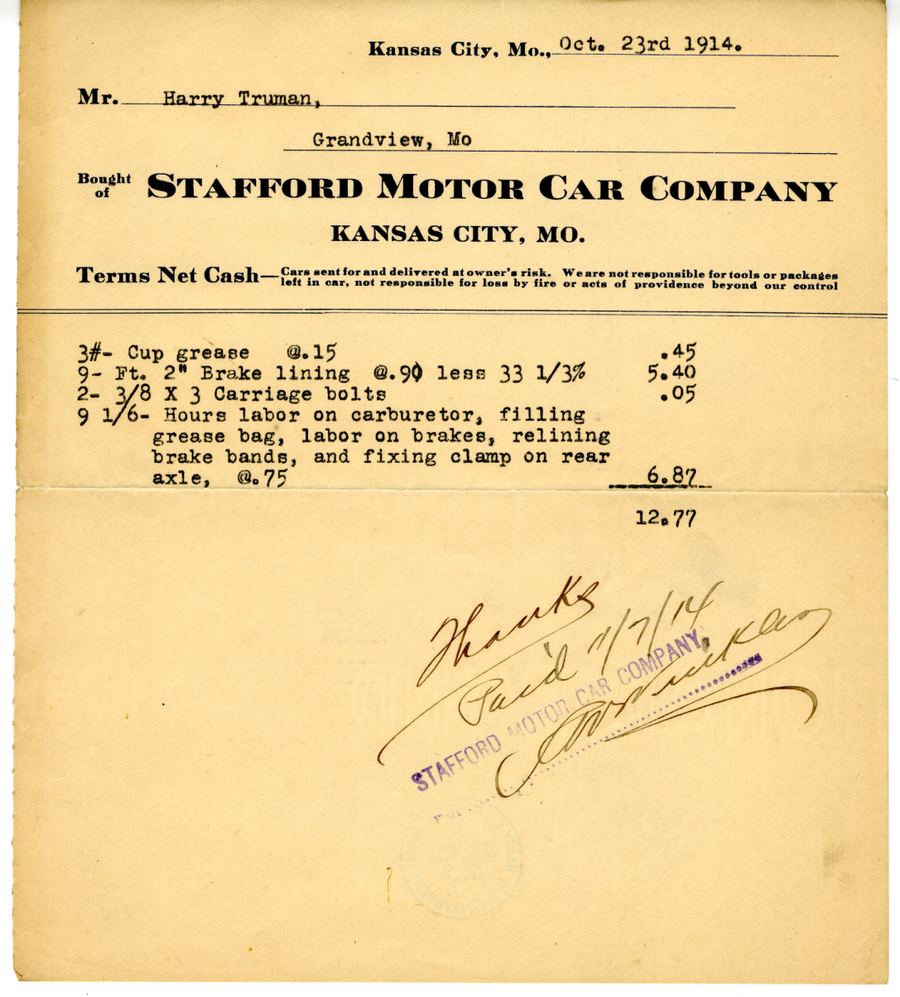
O início do resultado do talão da sapataria, tal como voltou.
Como é lido um PDF
Cada página, cada linha.
Os PDF chegam de programas de contabilidade, digitalizadores e anexos de e-mail, com e sem camada de texto. O Parsevix trata-os todos da mesma forma.
Cada página lida como imagem
O Parsevix converte cada página em imagem e lê-a por OCR, mesmo quando o PDF tem camada de texto, por isso também é lido o texto de carimbos, páginas digitalizadas e imagens incorporadas. O idioma é detetado em cada página, e as linhas seguem para a extração pela ordem de leitura.
- 02
As tabelas tornam-se listas
As linhas de uma tabela voltam como lista, um item por linha, também quando a tabela continua na página seguinte.
- 03
Documentos longos de uma só vez
Um PDF de até 30 páginas é lido e extraído como um único documento, por isso os totais e as linhas de itens de páginas diferentes ficam num só resultado.
- 04
Muitos idiomas e escritas
Escrita latina, cirílica, grega, árabe, chinesa, japonesa e coreana, entre outras; o idioma é detetado em cada página.
- 05
Dados pessoais mascarados
Os nomes, moradas e números são mascarados automaticamente antes de qualquer texto seguir para o modelo de IA e voltam a ser postos no seu resultado. A deteção apanha a maior parte dos dados pessoais, mas não necessariamente todos.
- 06
Cada valor ligado à sua página
Cada valor está ligado ao ponto da página de onde veio. Clique nele no painel para ver onde estava impresso.
- 07
PDF da sua caixa de correio
Reencaminhe e-mails com PDF em anexo para o endereço do seu projeto, e cada anexo torna-se um documento.
Como chegam os PDF
Carregue-os, reencaminhe-os ou envie-os a partir do seu sistema.
Painel
Arraste PDF para o painel, um de cada vez ou muitos de uma vez. Verifique cada resultado ao lado das suas páginas e aprove-o.
Endereço de e-mail
Planos pagosCada projeto tem o seu próprio endereço. Reencaminhe para lá os PDF, e cada anexo torna-se um documento.
API
Envie PDF a partir do seu próprio sistema e receba o JSON na mesma resposta, ou receba os resultados por webhook assinado ou pelo Zapier.
Pedido
curl https://parsevix.com/api/v1/extract-auto \
  -H "X-API-Key: $PARSEVIX_API_KEY" \
  -F file=@invoice.pdf
O pedido fica aberto até o documento ser lido e responde com o JSON.
- POST /documentsCarregar sem esperar; o resultado chega por webhook ou callback.
- POST /extract-autoSem categoria: cada campo que o Parsevix encontra, com o nome que tem no documento.
- POST /classifySó a categoria do documento, por 1 crédito.
Resposta · abreviada
Segurança e conformidade
- Dados pessoais mascaradosautomaticamente, antes da etapa de IA
- Encriptadoem trânsito e em repouso
- Sem treino de IAcom os seus documentos
- Ficheiros da API eliminadosapós o processamento
Paga por página, não por funcionalidade.
Todos os planos leem, classificam e mascaram os documentos da mesma forma. A escolha da categoria está incluída, e um documento que falha não custa nada.
Ver preços- crédito por página
- 1
- páginas grátis todos os meses
- 20
- por mês para 500 páginas
- $39
FAQ sobre PDF para JSON
PDF para JSON,
as respostas.
O que se pergunta antes de converter os primeiros PDF.
Até 10 MB e 30 páginas por ficheiro. Um PDF mais longo tem de ser dividido em vários ficheiros, e cada parte volta como um resultado próprio.
Sim. Cada página é lida como imagem, por isso uma digitalização sem camada de texto é lida da mesma forma que um PDF saído diretamente de um programa de contabilidade.
Um PDF que pede uma palavra-passe para abrir não pode ser lido e falha com um erro claro. Remova a palavra-passe e carregue-o de novo.
Sim. Um ficheiro Word (DOCX) é primeiro convertido em PDF e depois lido como qualquer outro PDF.
Um crédito por página: um PDF de dez páginas usa dez. A escolha da categoria está incluída e, se um documento falhar, os seus créditos são devolvidos.
Os PDF carregados no painel ou enviados por e-mail ficam no seu projeto até os eliminar. Os ficheiros enviados através da API são eliminados após o processamento, a menos que opte por guardá-los para o projeto. Os seus documentos nunca são usados para treinar IA.
Casos de utilização relacionados
Documentos que acompanham este.
Extração de faturas
Fornecedor, totais, IVA e cada linha de itens de faturas de qualquer formato.
Extração de dados de contratos
Partes, datas, valor e cláusulas principais de um contrato.
Conversor de extratos
Conta, saldos e cada movimento de extratos em PDF.