
API de OCR
Entram ficheiros. Sai JSON.
Envie um PDF, um ficheiro Word ou uma imagem para um único endpoint. O Parsevix lê cada página com OCR, mascara os dados pessoais e devolve os dados do documento como JSON, nos seus próprios campos ou com os rótulos do próprio documento. Experimente com os documentos reais da demo.
- OCR integrado, também para digitalizações e fotos
- JSON estruturado, não texto em bruto
- Síncrona, ou por webhook
Sem cartão de crédito · 20 páginas grátis todos os meses
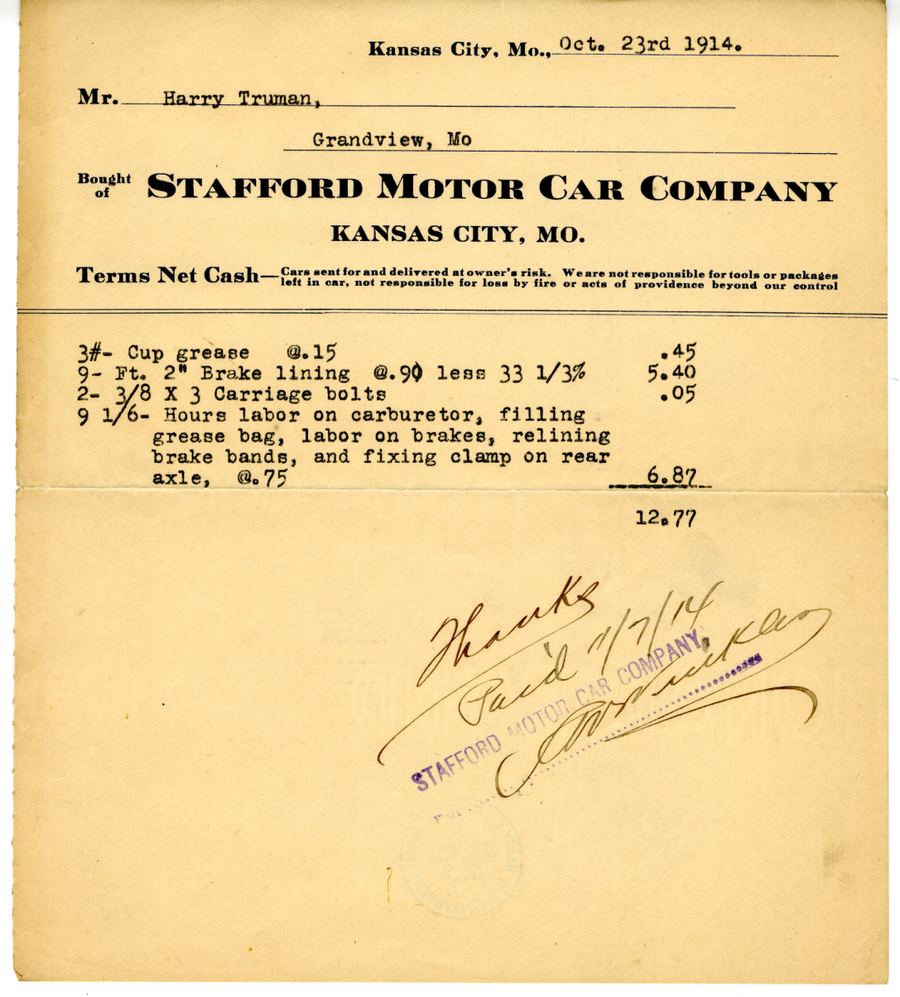
Nada é carregado: a demo reproduz o resultado guardado.
O pedido e a resposta
Uma chamada, tudo na resposta.
Painel
Experimente primeiro documentos no painel: cada resultado aparece ao lado da sua página, com cada valor assinalado onde foi lido.
Endereço de e-mail
Planos pagosCada projeto tem o seu próprio endereço. Os documentos reencaminhados para lá são processados como qualquer carregamento, e os resultados podem chegar-lhe por webhook.
API
Envie o ficheiro com a sua chave de API. A resposta é JSON: os campos do documento, o seu idioma e o número de páginas.
Pedido
curl https://parsevix.com/api/v1/extract-auto \
  -H "X-API-Key: $PARSEVIX_API_KEY" \
  -F file=@invoice.pdf
O pedido fica aberto até o documento ser lido e responde com o JSON.
- POST /documentsCarregar sem esperar; o resultado chega por webhook ou callback.
- POST /extract-autoSem categoria: cada campo que o Parsevix encontra, com o nome que tem no documento.
- POST /classifySó a categoria do documento, por 1 crédito.
Resposta · abreviada
Feita para programadores
OCR e extração numa só chamada.
Um pedido por documento, uma resposta JSON. Eis o que a API lhe dá.
OCR integrado
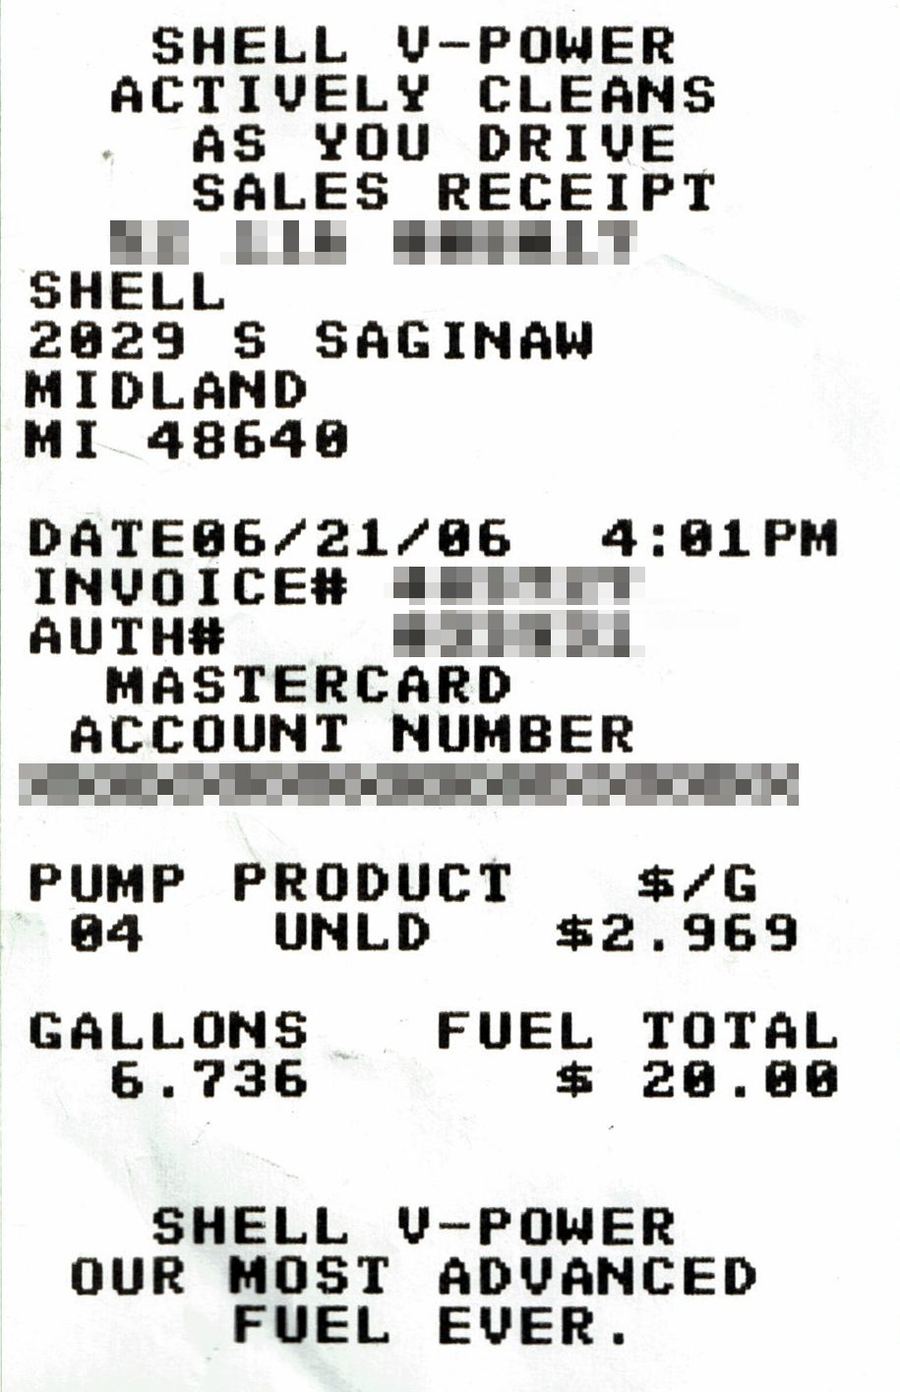
Não precisa de um motor de OCR próprio. O Parsevix renderiza cada página e lê-a, digitalizações e fotos de telemóvel incluídas, endireita as páginas deitadas ou de pernas para o ar e deteta o idioma em cada página. Os campos são extraídos do que foi lido e recebe JSON de volta.
- 02
As escritas que lê
Latina, chinesa e japonesa, e com modelos dedicados cirílica, grega, árabe, coreana, devanágari, tailandesa, tâmil e télugo. O hebraico, o arménio e o georgiano ainda não são lidos.
- 03
Síncrona por predefinição
POST /api/v1/extract espera até o documento ser lido e responde com o resultado. Até 5 pedidos abertos por chave e 30 páginas por ficheiro.
- 04
Ou assíncrona
POST /api/v1/documents responde de imediato; o resultado segue depois por webhook assinado, por um URL de callback ou pelo Zapier.
- 05
Limites por plano
De 10 pedidos por minuto por chave no plano gratuito a 300 no Business. Todos os planos leem os documentos da mesma forma.
- 06
Uma só forma de erro
Cada erro é { "error": { "code", "message" } } com um código estável separado por pontos, para que o seu código distinga uma quota esgotada de um ficheiro ilegível.
- 07
Ficheiros eliminados após o processamento
Os ficheiros enviados através da API são eliminados assim que o resultado sai, a menos que opte por guardá-los para o projeto.
Segurança e conformidade
- Dados pessoais mascaradosautomaticamente, antes da etapa de IA
- Encriptadoem trânsito e em repouso
- Sem treino de IAcom os seus documentos
- Ficheiros da API eliminadosapós o processamento
Paga por página, não por funcionalidade.
Todos os planos leem, classificam e mascaram os documentos da mesma forma. A escolha da categoria está incluída, e um documento que falha não custa nada.
Ver preços- crédito por página
- 1
- páginas grátis todos os meses
- 20
- por mês para 500 páginas
- $39
FAQ sobre a API de OCR
A API de OCR,
as respostas.
O que os programadores perguntam antes do primeiro pedido.
Não. O OCR faz parte de cada pedido: o Parsevix lê as páginas sozinho e responde com os dados do documento em JSON, por um crédito por página. Não há um endpoint separado para texto em bruto.
Documentos em escrita latina, cirílica, grega, árabe, chinesa, japonesa e coreana, entre outras; o idioma é detetado em cada página. O hebraico, o arménio, o georgiano, o bengali, o guzerate e o punjabi ainda não são lidos.
O texto impresso e datilografado funciona melhor. A letra manuscrita é lida onde é clara; o que não se consegue ler fica vazio em vez de ser adivinhado.
Um pedido síncrono espera até 285 segundos, o suficiente para 30 páginas. Uma espera mais longa responde com um tempo limite excedido; para grandes lotes, use o carregamento assíncrono com um webhook.
A API é HTTP simples, com carregamentos multipart e respostas JSON; a documentação tem exemplos prontos para cURL, Python e Node.js, e o Zapier liga-a sem código.
Os ficheiros enviados através da API são eliminados após o processamento, a menos que opte por guardá-los para o projeto. Os seus documentos nunca são usados para treinar IA.
Casos de utilização relacionados
Documentos que acompanham este.
Extração de faturas
Fornecedor, totais, IVA e cada linha de itens de faturas de qualquer formato.
OCR de talões
Estabelecimento, data, total e IVA de talões em papel ou fotografados.
OCR de documentos de identificação
Nome, número, datas e as duas linhas MRZ de passaportes e cartões de identificação.