
PDF naar JSON
PDF's erin. JSON eruit.
Upload een PDF, digitaal of gescand, stuur hem door per e-mail of verstuur hem naar de API. Parsevix leest elke pagina en levert de gegevens als JSON, in uw eigen velden of benoemd met de eigen labels van het document. Probeer het met de echte documenten in de demo.
- Tekst-PDF's en gescande PDF's even goed
- Tot 30 pagina's per bestand
- Uw eigen velden, of helemaal geen schema
Geen creditcard · elke maand 20 gratis pagina's
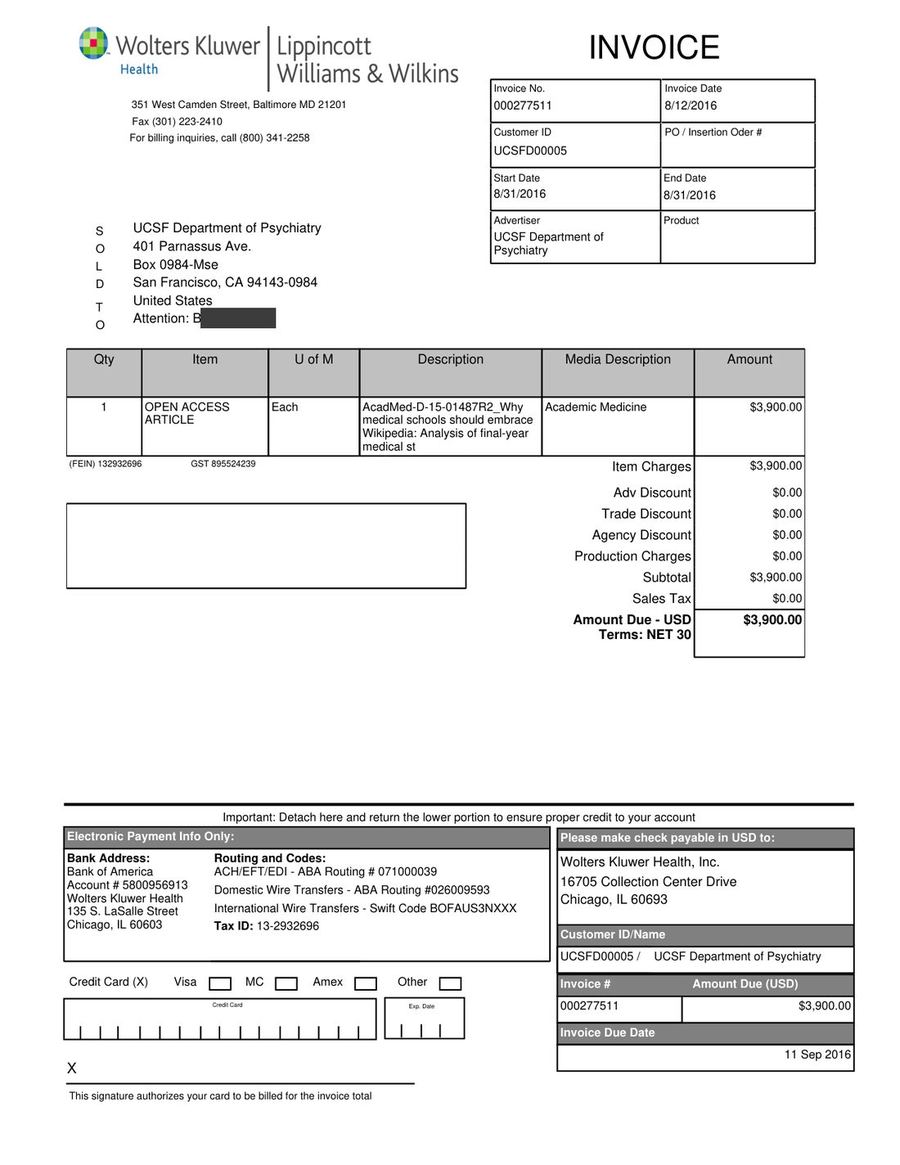
De namen van privépersonen hebben we zwart gemaakt. Er wordt niets geüpload: de demo speelt het opgeslagen resultaat af.
Twee manieren om de JSON vorm te geven
Uw schema, of helemaal geen.
Hetzelfde document kan terugkomen in de velden die u hebt vastgelegd, of in de velden die het zelf heeft. U kiest per upload, per e-mailadres of per API-aanroep.
Met een categorie
Benoem één keer de velden die u nodig hebt, of begin met een ingebouwde categorie zoals Invoice of Contract. Elk document van die soort komt in dezelfde vorm terug, met ISO-datums en gewone getallen.
- invoice_number
- invoice_date
- seller_info
- line_items
- total_due
- currency
Ingebouwde categorieën voor facturen, bonnen, contracten, identiteitsbewijzen en meer; uw eigen voor al het andere.
Zonder schema
Stuur het document zonder categorie en krijg elk veld dat Parsevix vindt, benoemd met de eigen labels van het document en in zijn taal, met de waarden zoals ze gedrukt staan. De demo hierboven werkt zo.
Het begin van het resultaat van de kassabon van de schoenenwinkel, zoals het terugkwam.
Hoe een PDF wordt gelezen
Elke pagina, elke regel.
PDF's komen uit boekhoudsystemen, scanners en e-mailbijlagen, met en zonder tekstlaag. Parsevix behandelt ze allemaal op dezelfde manier.
Elke pagina als afbeelding gelezen
Parsevix rendert elke pagina en leest die met OCR, ook als de PDF een tekstlaag heeft, zodat ook tekst in stempels, gescande pagina's en ingesloten afbeeldingen wordt gelezen. De taal wordt op elke pagina herkend, en de regels gaan in leesvolgorde naar de extractie.
- 02
Tabellen worden lijsten
De rijen van een tabel komen terug als lijst, één item per rij, ook als de tabel op de volgende pagina doorloopt.
- 03
Lange documenten in één keer
Een PDF van maximaal 30 pagina's wordt als één document gelezen en uitgelezen, zodat totalen en regels van verschillende pagina's in één resultaat terechtkomen.
- 04
Veel talen en schriften
Onder meer Latijns, Cyrillisch, Grieks, Arabisch, Chinees, Japans en Koreaans schrift; de taal wordt op elke pagina herkend.
- 05
Persoonsgegevens gemaskeerd
Namen, adressen en nummers worden automatisch gemaskeerd voordat er tekst naar het AI-model gaat, en teruggezet in uw resultaat. De herkenning vindt de meeste persoonsgegevens, maar niet per se elk gegeven.
- 06
Elke waarde gekoppeld aan zijn pagina
Elke waarde is gekoppeld aan de plek op de pagina waar ze vandaan komt. Klik erop in het dashboard om te zien waar ze stond.
- 07
PDF's uit uw mailbox
Stuur e-mails met PDF-bijlagen door naar het adres van uw project, en elke bijlage wordt een document.
Hoe PDF's binnenkomen
Upload ze, stuur ze door of verstuur ze vanuit uw systeem.
Dashboard
Sleep PDF's naar het dashboard, één voor één of veel tegelijk. Controleer elk resultaat naast de pagina's en keur het goed.
E-mailadres
Betaalde abonnementenElk project krijgt een eigen adres. Stuur PDF's daarheen door, en elke bijlage wordt een document.
API
Verstuur PDF's vanuit uw eigen systeem en krijg de JSON in hetzelfde antwoord, of ontvang resultaten via een ondertekende webhook of via Zapier.
Verzoek
curl https://parsevix.com/api/v1/extract-auto \
  -H "X-API-Key: $PARSEVIX_API_KEY" \
  -F file=@invoice.pdf
Het verzoek blijft open tot het document is gelezen en antwoordt met de JSON.
- POST /documentsUploaden zonder te wachten; het resultaat komt via webhook of callback.
- POST /extract-autoZonder categorie: elk veld dat Parsevix vindt, genoemd zoals in het document.
- POST /classifyAlleen de categorie van het document, voor 1 credit.
Antwoord · ingekort
Beveiliging & compliance
- Persoonsgegevens gemaskeerdautomatisch, vóór de AI-stap
- Versleuteldtijdens overdracht en in opslag
- Geen AI-trainingmet uw documenten
- API-bestanden verwijderdna verwerking
Betalen per pagina, niet per functie.
Elk abonnement leest, sorteert en maskeert documenten op dezelfde manier. Het kiezen van de categorie is inbegrepen, en een mislukt document kost niets.
Bekijk de prijzen- credit per pagina
- 1
- gratis pagina's per maand
- 20
- per maand voor 500 pagina's
- $39
FAQ over PDF naar JSON
PDF naar JSON,
beantwoord.
Wat mensen vragen voordat ze hun eerste PDF's omzetten.
Nog een vraag?
Schrijf ons. Elk bericht wordt door een mens gelezen.
Tot 10 MB en 30 pagina's per bestand. Een langere PDF moet over meerdere bestanden worden verdeeld, en elk deel komt terug als een eigen resultaat.
Ja. Elke pagina wordt als afbeelding gelezen, dus een scan zonder tekstlaag wordt net zo gelezen als een PDF die rechtstreeks uit een boekhoudsysteem komt.
Een PDF die een wachtwoord vraagt om te openen, kan niet worden gelezen en mislukt met een duidelijke foutmelding. Verwijder het wachtwoord en upload hem dan opnieuw.
Ja. Een Word-bestand (DOCX) wordt eerst omgezet naar PDF en daarna gelezen zoals elke andere PDF.
Eén credit per pagina: een PDF van tien pagina's gebruikt er tien. Het kiezen van de categorie is inbegrepen, en mislukt een document, dan krijgt u de credits terug.
PDF's die in het dashboard zijn geüpload of per e-mail zijn gestuurd, blijven in uw project tot u ze verwijdert. Bestanden die via de API zijn verstuurd, worden na verwerking verwijderd, tenzij u het bewaren ervan voor het project inschakelt. Uw documenten worden nooit gebruikt om AI te trainen.
Verwante toepassingen
Documenten die met dit document meereizen.
Facturen uitlezen
Leverancier, totalen, btw en elke factuurregel uit facturen in elke opmaak.
Contracten uitlezen
Partijen, datums, waarde en de belangrijkste clausules van een contract.
Bankafschriften uitlezen
Rekening, saldi en elke transactie uit afschriften als PDF.