
OCR-API
Bestanden erin. JSON eruit.
Stuur een PDF, een Word-bestand of een afbeelding naar één endpoint. Parsevix leest elke pagina met OCR, maskeert persoonsgegevens en geeft de gegevens van het document terug als JSON, in uw eigen velden of met de eigen labels van het document. Probeer het met de echte documenten in de demo.
- OCR ingebouwd, ook voor scans en foto's
- Gestructureerde JSON, geen ruwe tekst
- Synchroon, of via webhook
Geen creditcard · elke maand 20 gratis pagina's
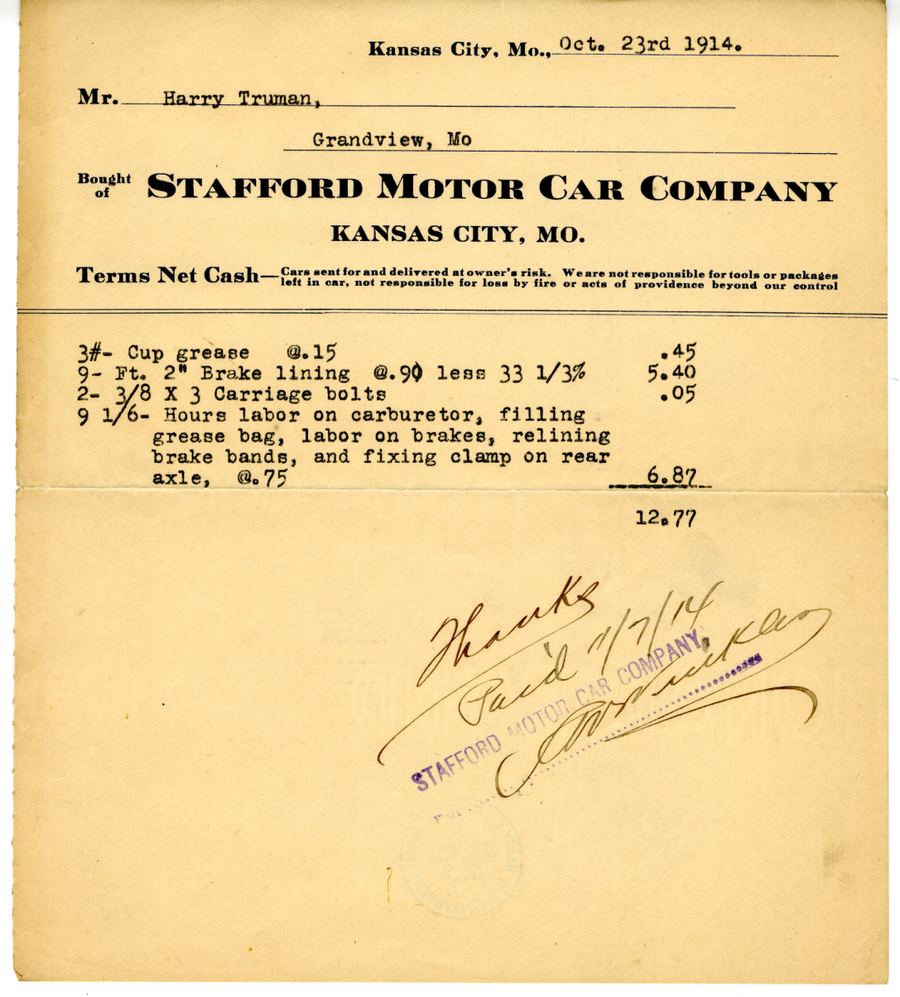
Er wordt niets geüpload: de demo speelt het opgeslagen resultaat af.
Het verzoek en het antwoord
Eén aanroep, alles in het antwoord.
Dashboard
Probeer documenten eerst in het dashboard: elk resultaat staat naast de pagina, met elke waarde gemarkeerd waar ze is gelezen.
E-mailadres
Betaalde abonnementenElk project krijgt een eigen adres. Documenten die daarheen worden doorgestuurd, worden verwerkt zoals elke upload, en hun resultaten kunnen u via een webhook bereiken.
API
Verstuur het bestand met uw API-sleutel. Het antwoord is JSON: de velden van het document, de taal en het aantal pagina's.
Verzoek
curl https://parsevix.com/api/v1/extract-auto \
  -H "X-API-Key: $PARSEVIX_API_KEY" \
  -F file=@invoice.pdf
Het verzoek blijft open tot het document is gelezen en antwoordt met de JSON.
- POST /documentsUploaden zonder te wachten; het resultaat komt via webhook of callback.
- POST /extract-autoZonder categorie: elk veld dat Parsevix vindt, genoemd zoals in het document.
- POST /classifyAlleen de categorie van het document, voor 1 credit.
Antwoord · ingekort
Gebouwd voor ontwikkelaars
OCR en extractie in één aanroep.
Eén verzoek per document, één JSON-antwoord. Dit geeft de API u.
OCR ingebouwd
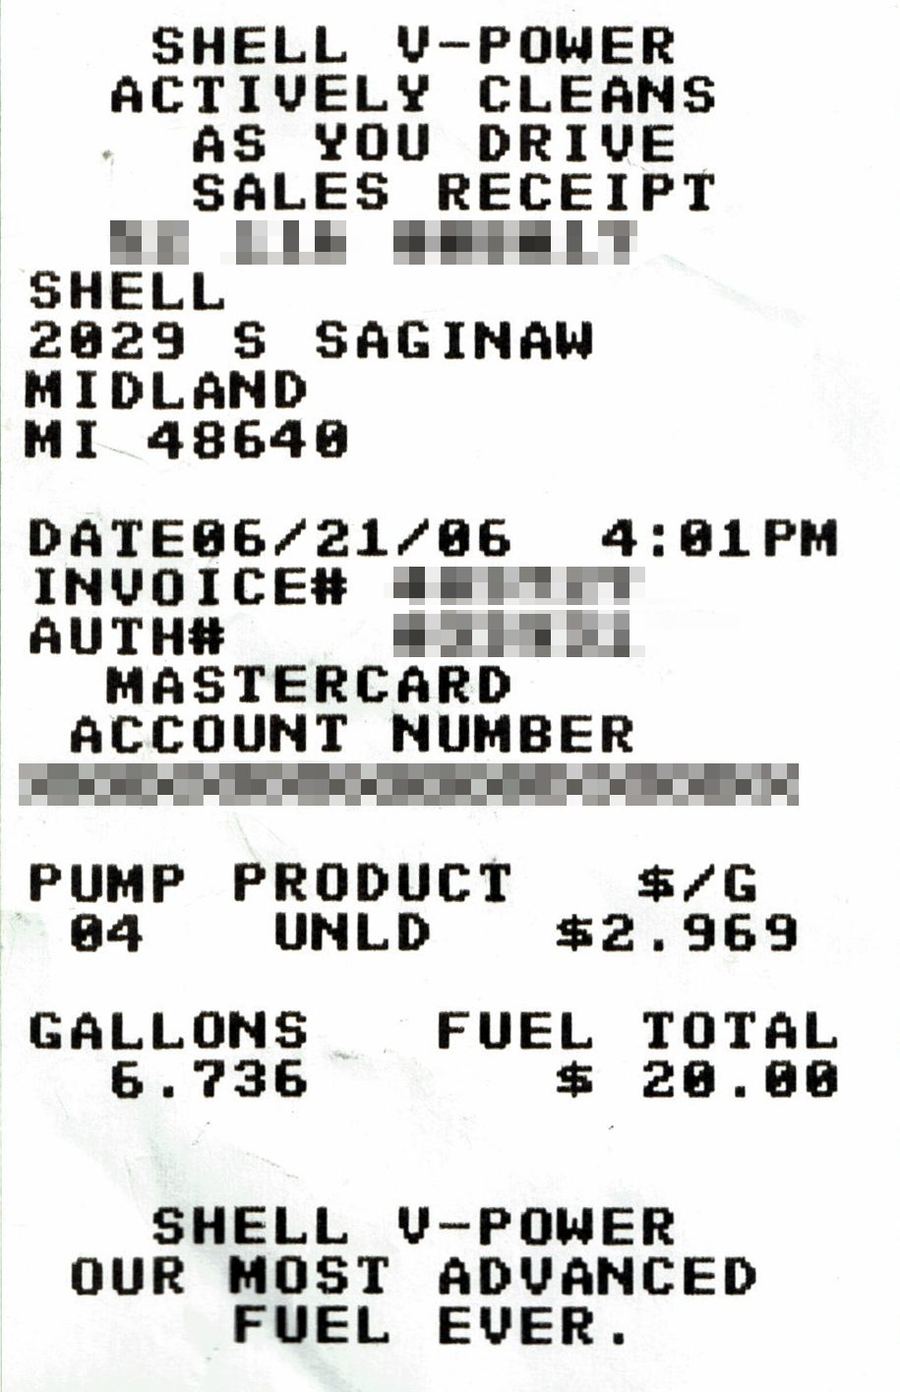
U hebt geen eigen OCR-engine nodig. Parsevix rendert elke pagina en leest die, ook scans en telefoonfoto's, zet pagina's die op hun kant of ondersteboven liggen recht en herkent de taal op elke pagina. De velden worden uit het gelezene gehaald en u krijgt JSON terug.
- 02
Welke schriften het leest
Latijns, Chinees en Japans, en met eigen modellen Cyrillisch, Grieks, Arabisch, Koreaans, Devanagari, Thai, Tamil en Telugu. Hebreeuws, Armeens en Georgisch worden nog niet gelezen.
- 03
Standaard synchroon
POST /api/v1/extract wacht tot het document is gelezen en antwoordt met het resultaat. Tot 5 open verzoeken per sleutel en 30 pagina's per bestand.
- 04
Of asynchroon
POST /api/v1/documents antwoordt meteen; het resultaat volgt via een ondertekende webhook, via een callback-URL of via Zapier.
- 05
Limieten per abonnement
Van 10 verzoeken per minuut per sleutel op het gratis abonnement tot 300 op Business. Elk abonnement leest documenten op dezelfde manier.
- 06
Eén foutvorm
Elke fout is { "error": { "code", "message" } } met een stabiele code met punten, zodat uw code een opgebruikt quotum kan onderscheiden van een onleesbaar bestand.
- 07
Bestanden na verwerking verwijderd
Bestanden die via de API zijn verstuurd, worden verwijderd zodra het resultaat de deur uit is, tenzij u het bewaren ervan voor het project inschakelt.
Beveiliging & compliance
- Persoonsgegevens gemaskeerdautomatisch, vóór de AI-stap
- Versleuteldtijdens overdracht en in opslag
- Geen AI-trainingmet uw documenten
- API-bestanden verwijderdna verwerking
Betalen per pagina, niet per functie.
Elk abonnement leest, sorteert en maskeert documenten op dezelfde manier. Het kiezen van de categorie is inbegrepen, en een mislukt document kost niets.
Bekijk de prijzen- credit per pagina
- 1
- gratis pagina's per maand
- 20
- per maand voor 500 pagina's
- $39
FAQ over de OCR-API
De OCR-API,
beantwoord.
Wat ontwikkelaars vragen voor hun eerste verzoek.
Nog een vraag?
Schrijf ons. Elk bericht wordt door een mens gelezen.
Nee. OCR zit in elk verzoek: Parsevix leest de pagina's zelf en antwoordt met de gegevens van het document als JSON, voor één credit per pagina. Een apart endpoint voor ruwe tekst is er niet.
Documenten in onder meer Latijns, Cyrillisch, Grieks, Arabisch, Chinees, Japans en Koreaans schrift; de taal wordt op elke pagina herkend. Hebreeuws, Armeens, Georgisch, Bengaals, Gujarati en Punjabi worden nog niet gelezen.
Gedrukte en getypte tekst werkt het best. Handschrift wordt gelezen waar het duidelijk is; wat niet te lezen is, blijft leeg in plaats van geraden te worden.
Een synchroon verzoek wacht tot 285 seconden, genoeg voor 30 pagina's. Duurt het langer, dan volgt een time-out; gebruik voor grote batches de asynchrone upload met een webhook.
De API is gewoon HTTP met multipart-uploads en JSON-antwoorden; de documentatie heeft kant-en-klare voorbeelden voor cURL, Python en Node.js, en Zapier koppelt hem zonder code.
Bestanden die via de API zijn verstuurd, worden na verwerking verwijderd, tenzij u het bewaren ervan voor het project inschakelt. Uw documenten worden nooit gebruikt om AI te trainen.
Verwante toepassingen
Documenten die met dit document meereizen.
Facturen uitlezen
Leverancier, totalen, btw en elke factuurregel uit facturen in elke opmaak.
Bonnetjes uitlezen
Winkel, datum, totaal en btw van papieren en gefotografeerde bonnetjes.
ID-documenten uitlezen
Naam, nummer, datums en beide MRZ-regels uit paspoorten en identiteitskaarten.