
PDF a JSON
Entran PDF. Sale JSON.
Suba un PDF, digital o escaneado, reenvíelo por correo o mándelo a la API. Parsevix lee cada página y devuelve los datos como JSON, en sus propios campos o con los nombres de las etiquetas del propio documento. Pruébelo con los documentos reales de la demo.
- PDF de texto y PDF escaneados por igual
- Hasta 30 páginas por archivo
- Sus propios campos, o sin ningún esquema
Sin tarjeta de crédito · 20 páginas gratis cada mes
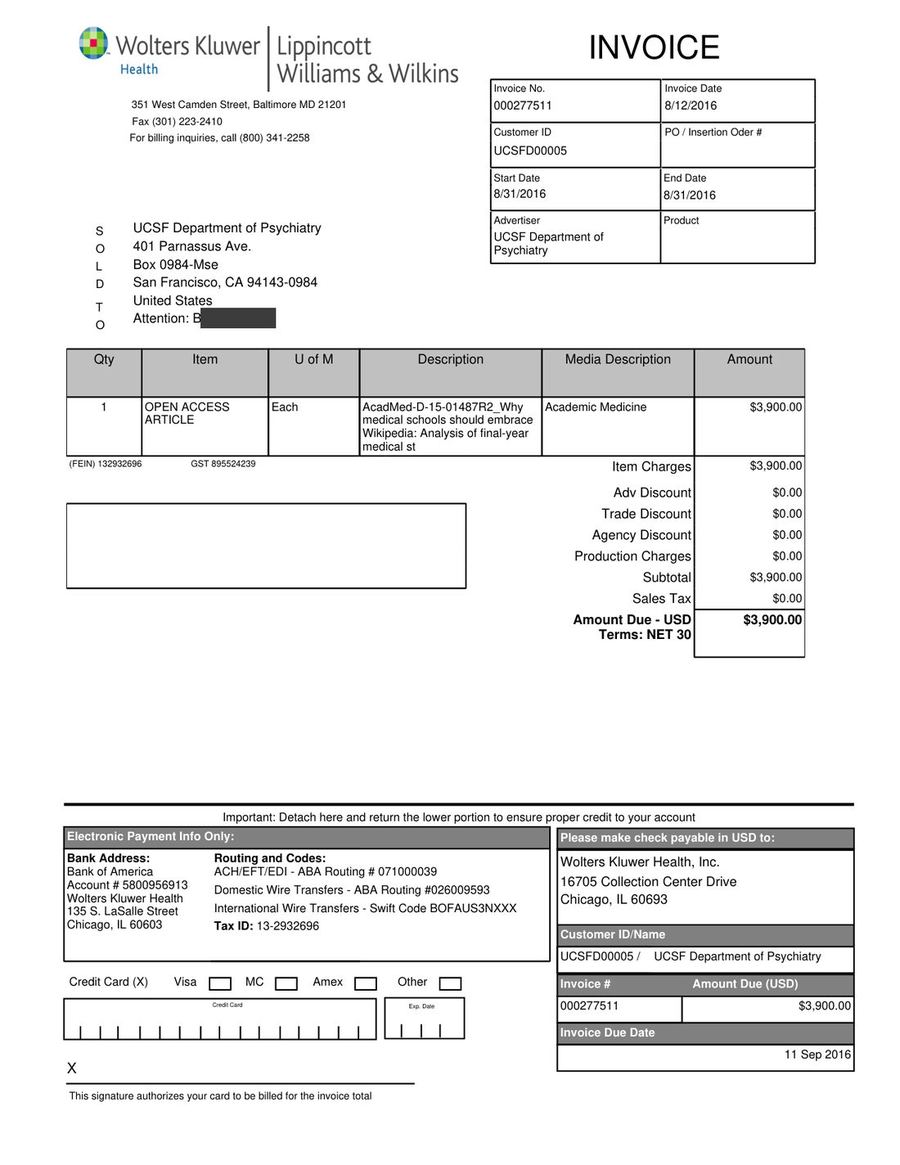
Hemos tachado los nombres de particulares. No se sube nada: la demo reproduce el resultado guardado.
Dos formas de dar forma al JSON
Su esquema, o ninguno.
El mismo documento puede volver con los campos que usted definió o con los campos que él mismo tiene. Elija por subida, por dirección de correo o por llamada a la API.
Con una categoría
Nombre una vez los campos que necesita, o parta de una categoría integrada como Invoice o Contract. Cada documento de ese tipo vuelve con la misma estructura, con fechas ISO y números simples.
- invoice_number
- invoice_date
- seller_info
- line_items
- total_due
- currency
Categorías integradas para facturas, tickets, contratos, documentos de identidad y más; las suyas propias para todo lo demás.
Sin esquema
Envíe el documento sin categoría y obtenga cada campo que Parsevix encuentre, con los nombres de las etiquetas del propio documento y en su idioma, y los valores tal como están impresos. La demo de arriba funciona así.
El principio del resultado del ticket de la zapatería, tal como volvió.
Cómo se lee un PDF
Cada página, cada línea.
Los PDF llegan de programas de contabilidad, escáneres y adjuntos de correo, con y sin capa de texto. Parsevix los trata todos igual.
Cada página se lee como imagen
Parsevix renderiza cada página y la lee con OCR, incluso cuando el PDF tiene capa de texto, así que también se lee el texto de sellos, páginas escaneadas e imágenes incrustadas. El idioma se detecta en cada página, y las líneas pasan a la extracción en orden de lectura.
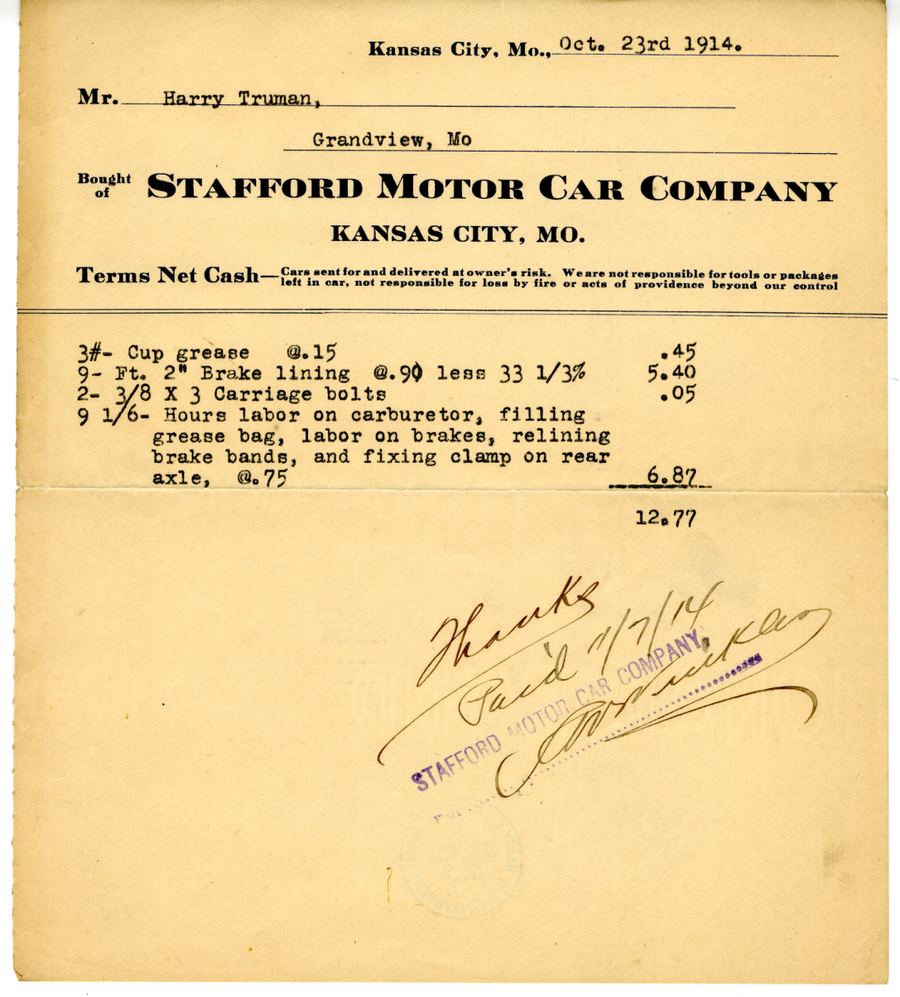
- 02
Las tablas se convierten en listas
Las filas de una tabla vuelven como una lista, un elemento por fila, también cuando la tabla continúa en la página siguiente.
- 03
Documentos largos de una vez
Un PDF de hasta 30 páginas se lee y se extrae como un solo documento, así que los totales y las partidas de páginas distintas acaban en un solo resultado.
- 04
Muchos idiomas y escrituras
Escritura latina, cirílica, griega, árabe, china, japonesa y coreana, entre otras; el idioma se detecta en cada página.
- 05
Datos personales enmascarados
Los nombres, direcciones y números se enmascaran automáticamente antes de que ningún texto vaya al modelo de IA y se vuelven a poner en su resultado. La detección encuentra la mayoría de los datos personales, pero no necesariamente todos.
- 06
Cada valor, vinculado a su página
Cada valor está vinculado al lugar de la página del que procede. Haga clic en él en el panel para ver dónde estaba impreso.
- 07
PDF desde su buzón
Reenvíe correos con PDF adjuntos a la dirección de su proyecto, y cada adjunto se convierte en un documento.
Cómo llegan los PDF
Súbalos, reenvíelos o mándelos desde su sistema.
Panel
Arrastre PDF al panel, de uno en uno o muchos a la vez. Revise cada resultado junto a sus páginas y apruébelo.
Dirección de correo
Planes de pagoCada proyecto tiene su propia dirección. Reenvíe ahí los PDF, y cada adjunto se convierte en un documento.
API
Envíe PDF desde su propio sistema y reciba el JSON en la misma respuesta, o reciba los resultados por webhook firmado o por Zapier.
Petición
curl https://parsevix.com/api/v1/extract-auto \
  -H "X-API-Key: $PARSEVIX_API_KEY" \
  -F file=@invoice.pdf
La petición queda abierta hasta que el documento se ha leído y responde con el JSON.
- POST /documentsSubir sin esperar; el resultado llega por webhook o callback.
- POST /extract-autoSin categoría: cada campo que Parsevix encuentra, con el nombre que tiene en el documento.
- POST /classifySolo la categoría del documento, por 1 crédito.
Respuesta · recortada
Seguridad y cumplimiento
- Datos personales enmascaradosautomáticamente, antes del paso de IA
- Cifradoen tránsito y en reposo
- Sin entrenamiento de IAcon sus documentos
- Archivos de la API eliminadostras el procesamiento
Se paga por página, no por funcionalidad.
Todos los planes leen, clasifican y enmascaran los documentos igual. La elección de la categoría está incluida, y un documento que falla no cuesta nada.
Ver precios- crédito por página
- 1
- páginas gratis cada mes
- 20
- al mes por 500 páginas
- $39
Preguntas sobre PDF a JSON
PDF a JSON:
dudas resueltas.
Lo que se pregunta antes de convertir los primeros PDF.
Hasta 10 MB y 30 páginas por archivo. Un PDF más largo hay que dividirlo en varios archivos, y cada parte vuelve como un resultado propio.
Sí. Cada página se lee como imagen, así que un escaneo sin capa de texto se lee igual que un PDF que sale directamente de un programa de contabilidad.
Un PDF que pide una contraseña para abrirse no se puede leer y falla con un error claro. Quite la contraseña y vuelva a subirlo.
Sí. Un archivo de Word (DOCX) se convierte primero en PDF y luego se lee como cualquier otro PDF.
Un crédito por página: un PDF de diez páginas usa diez. La elección de la categoría está incluida, y si un documento falla, se le devuelven sus créditos.
Los PDF subidos en el panel o enviados por correo se quedan en su proyecto hasta que los elimine. Los archivos enviados a través de la API se eliminan tras el procesamiento, salvo que active su conservación para el proyecto. Sus documentos nunca se usan para entrenar IA.
Casos de uso relacionados
Documentos que acompañan a este.
Extracción de facturas
Proveedor, totales, IVA y cada partida de facturas con cualquier diseño.
Extracción de datos de contratos
Partes, fechas, importe y cláusulas principales de un contrato.
Conversor de extractos
Cuenta, saldos y cada movimiento de extractos en PDF.