
API de OCR
Entran archivos. Sale JSON.
Envíe un PDF, un archivo de Word o una imagen a un solo endpoint. Parsevix lee cada página con OCR, enmascara los datos personales y devuelve los datos del documento como JSON, en sus propios campos o con los nombres que usa el propio documento. Pruébelo con los documentos reales de la demo.
- OCR integrado, también para escaneos y fotos
- JSON estructurado, no texto en bruto
- Síncrona, o por webhook
Sin tarjeta de crédito · 20 páginas gratis cada mes
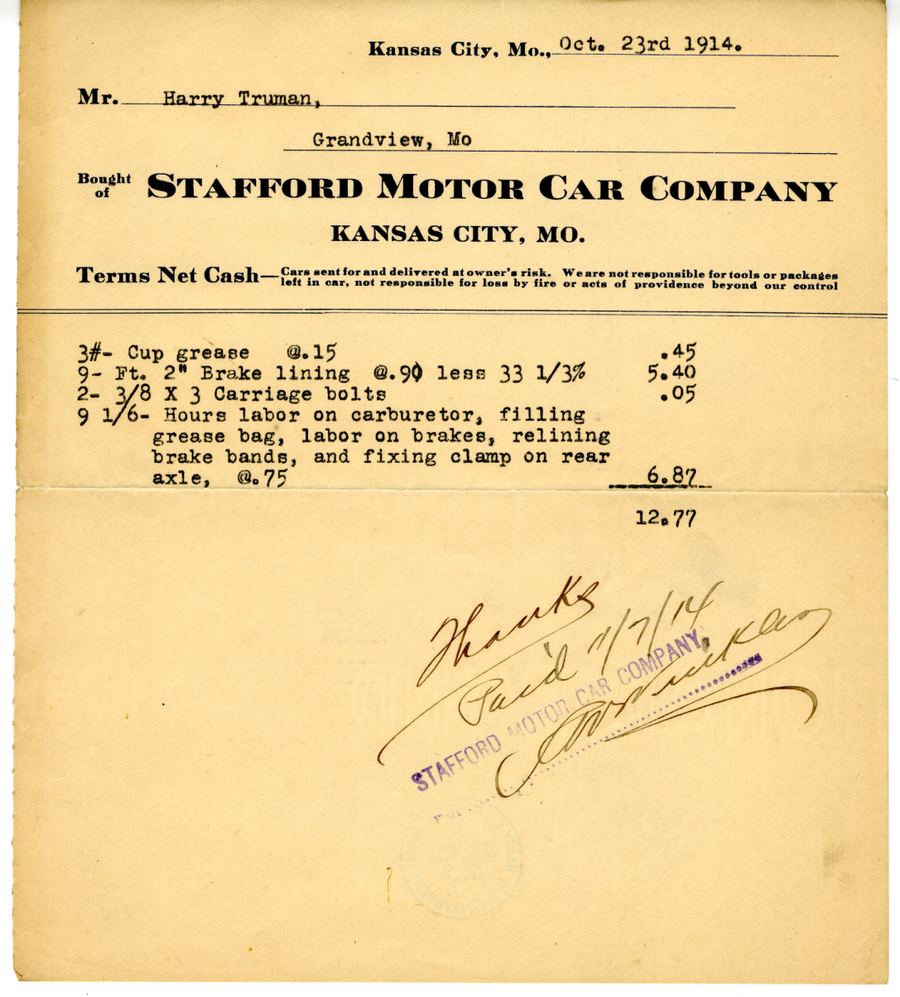
No se sube nada: la demo reproduce el resultado guardado.
La petición y la respuesta
Una llamada, todo en la respuesta.
Panel
Pruebe primero documentos en el panel: cada resultado se muestra junto a su página, con cada valor marcado donde se leyó.
Dirección de correo
Planes de pagoCada proyecto tiene su propia dirección. Los documentos reenviados ahí se procesan como cualquier subida, y sus resultados pueden llegarle por webhook.
API
Envíe el archivo con su clave de API. La respuesta es JSON: los campos del documento, su idioma y su número de páginas.
Petición
curl https://parsevix.com/api/v1/extract-auto \
  -H "X-API-Key: $PARSEVIX_API_KEY" \
  -F file=@invoice.pdf
La petición queda abierta hasta que el documento se ha leído y responde con el JSON.
- POST /documentsSubir sin esperar; el resultado llega por webhook o callback.
- POST /extract-autoSin categoría: cada campo que Parsevix encuentra, con el nombre que tiene en el documento.
- POST /classifySolo la categoría del documento, por 1 crédito.
Respuesta · recortada
Hecha para desarrolladores
OCR y extracción en una llamada.
Una petición por documento, una respuesta JSON. Esto es lo que le da la API.
OCR integrado
No necesita un motor de OCR propio. Parsevix renderiza cada página y la lee, incluidos escaneos y fotos de móvil, endereza las páginas que están de lado o del revés y detecta el idioma en cada página. Los campos se extraen de lo leído y usted recibe JSON.
- 02
Las escrituras que lee
Latina, china y japonesa, y con modelos propios cirílica, griega, árabe, coreana, devanagari, tailandesa, tamil y telugu. El hebreo, el armenio y el georgiano todavía no se leen.
- 03
Síncrona por defecto
POST /api/v1/extract espera hasta que el documento se ha leído y responde con el resultado. Hasta 5 peticiones abiertas por clave y 30 páginas por archivo.
- 04
O asíncrona
POST /api/v1/documents responde de inmediato; el resultado llega después por webhook firmado, por una URL de callback o por Zapier.
- 05
Límites por plan
Desde 10 peticiones por minuto y clave en el plan gratuito hasta 300 en Business. Todos los planes leen los documentos de la misma manera.
- 06
Una sola forma de error
Cada error es { "error": { "code", "message" } } con un código estable separado por puntos, para que su código distinga una cuota agotada de un archivo ilegible.
- 07
Archivos eliminados tras el procesamiento
Los archivos enviados a través de la API se eliminan en cuanto sale el resultado, salvo que active su conservación para el proyecto.
Seguridad y cumplimiento
- Datos personales enmascaradosautomáticamente, antes del paso de IA
- Cifradoen tránsito y en reposo
- Sin entrenamiento de IAcon sus documentos
- Archivos de la API eliminadostras el procesamiento
Se paga por página, no por funcionalidad.
Todos los planes leen, clasifican y enmascaran los documentos igual. La elección de la categoría está incluida, y un documento que falla no cuesta nada.
Ver precios- crédito por página
- 1
- páginas gratis cada mes
- 20
- al mes por 500 páginas
- $39
Preguntas sobre la API de OCR
La API de OCR:
dudas resueltas.
Lo que preguntan los desarrolladores antes de su primera petición.
No. El OCR forma parte de cada petición: Parsevix lee las páginas por sí mismo y responde con los datos del documento en JSON, por un crédito por página. No hay un endpoint aparte para texto en bruto.
Documentos en escritura latina, cirílica, griega, árabe, china, japonesa y coreana, entre otras; el idioma se detecta en cada página. El hebreo, el armenio, el georgiano, el bengalí, el guyaratí y el panyabí todavía no se leen.
El texto impreso y mecanografiado funciona mejor. La letra manuscrita se lee donde es clara; lo que no se puede leer queda vacío en lugar de adivinarse.
Una petición síncrona espera hasta 285 segundos, suficiente para 30 páginas. Si la espera es mayor, la respuesta es un tiempo de espera agotado; para lotes grandes, use la subida asíncrona con un webhook.
La API es HTTP sencillo con subidas multipart y respuestas JSON; la documentación tiene ejemplos listos para cURL, Python y Node.js, y Zapier la conecta sin código.
Los archivos enviados a través de la API se eliminan tras el procesamiento, salvo que active su conservación para el proyecto. Sus documentos nunca se usan para entrenar IA.
Casos de uso relacionados
Documentos que acompañan a este.
Extracción de facturas
Proveedor, totales, IVA y cada partida de facturas con cualquier diseño.
OCR de tickets
Comercio, fecha, total e impuestos de tickets en papel o fotografiados.
OCR de documentos de identidad
Nombre, número, fechas y las dos líneas MRZ de pasaportes y documentos de identidad.