
PDF do JSON
PDF wchodzi. JSON wychodzi.
Prześlij PDF, cyfrowy lub zeskanowany, przekaż go e-mailem albo wyślij do API. Parsevix czyta każdą stronę i zwraca dane jako JSON, we własnych polach albo nazwane etykietami z samego dokumentu. Wypróbuj to na prawdziwych dokumentach w demo.
- PDF-y tekstowe i zeskanowane tak samo
- Do 30 stron na plik
- Własne pola albo zupełnie bez schematu
Bez karty kredytowej · 20 darmowych stron co miesiąc
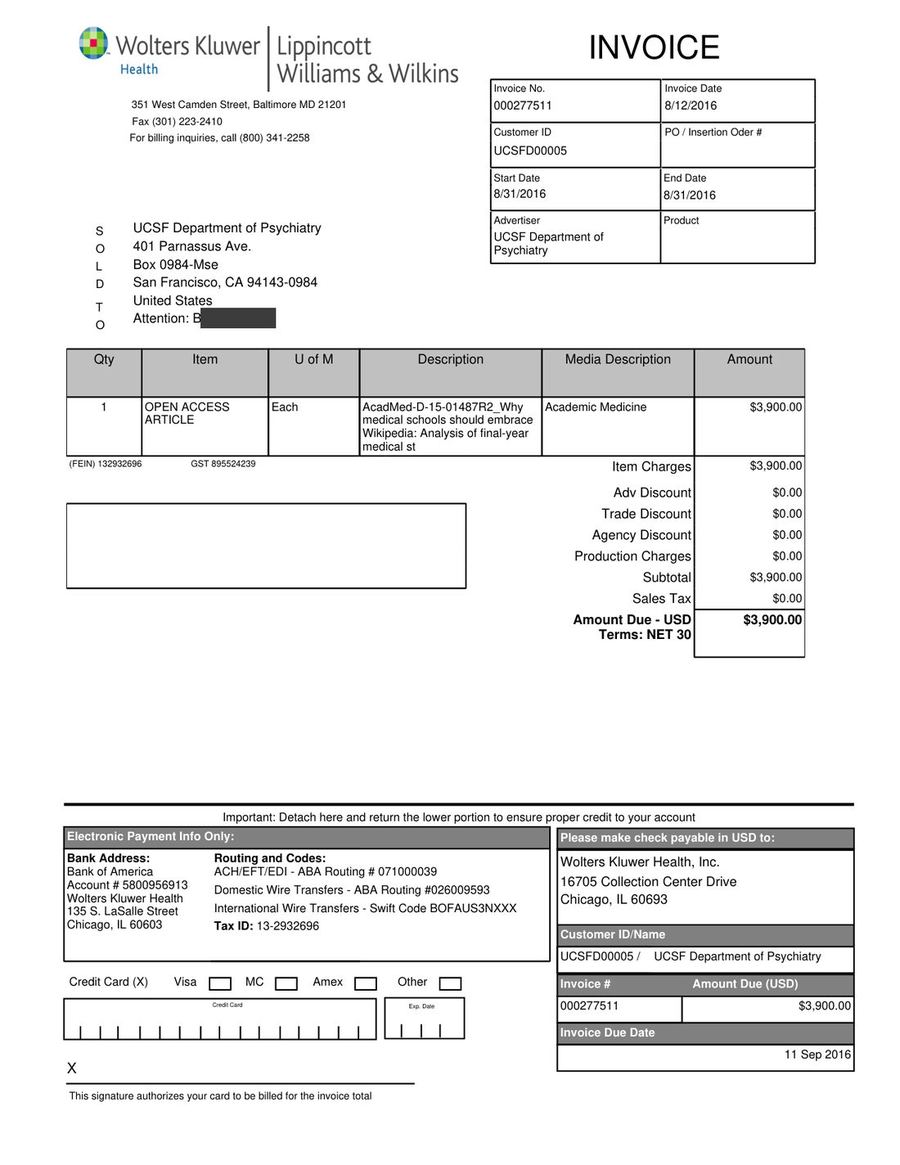
Zaczerniliśmy nazwiska osób prywatnych. Nic nie jest przesyłane: demo odtwarza zapisany wynik.
Dwa sposoby na kształt JSON-a
Twój schemat albo żaden.
Ten sam dokument może wrócić w polach, które zdefiniujesz, albo w polach, które sam zawiera. Wybierasz dla każdego przesłania, adresu e-mail lub wywołania API.
Z kategorią
Nazwij raz potrzebne pola albo zacznij od wbudowanej kategorii, takiej jak Invoice czy Contract. Każdy dokument tego rodzaju wraca w tym samym kształcie, z datami ISO i zwykłymi liczbami.
- invoice_number
- invoice_date
- seller_info
- line_items
- total_due
- currency
Wbudowane kategorie dla faktur, paragonów, umów, dokumentów tożsamości i nie tylko; własne dla całej reszty.
Bez schematu
Wyślij dokument bez kategorii i otrzymaj każde pole, które Parsevix znajdzie, nazwane etykietami z samego dokumentu i w jego języku, z wartościami tak, jak są wydrukowane. Demo powyżej działa właśnie tak.
Początek wyniku dla paragonu ze sklepu obuwniczego, tak jak wrócił.
Jak czytany jest PDF
Każda strona, każda linia.
PDF-y przychodzą z systemów księgowych, skanerów i załączników e-mail, z warstwą tekstową i bez niej. Parsevix traktuje je wszystkie tak samo.
Każda strona czytana jako obraz
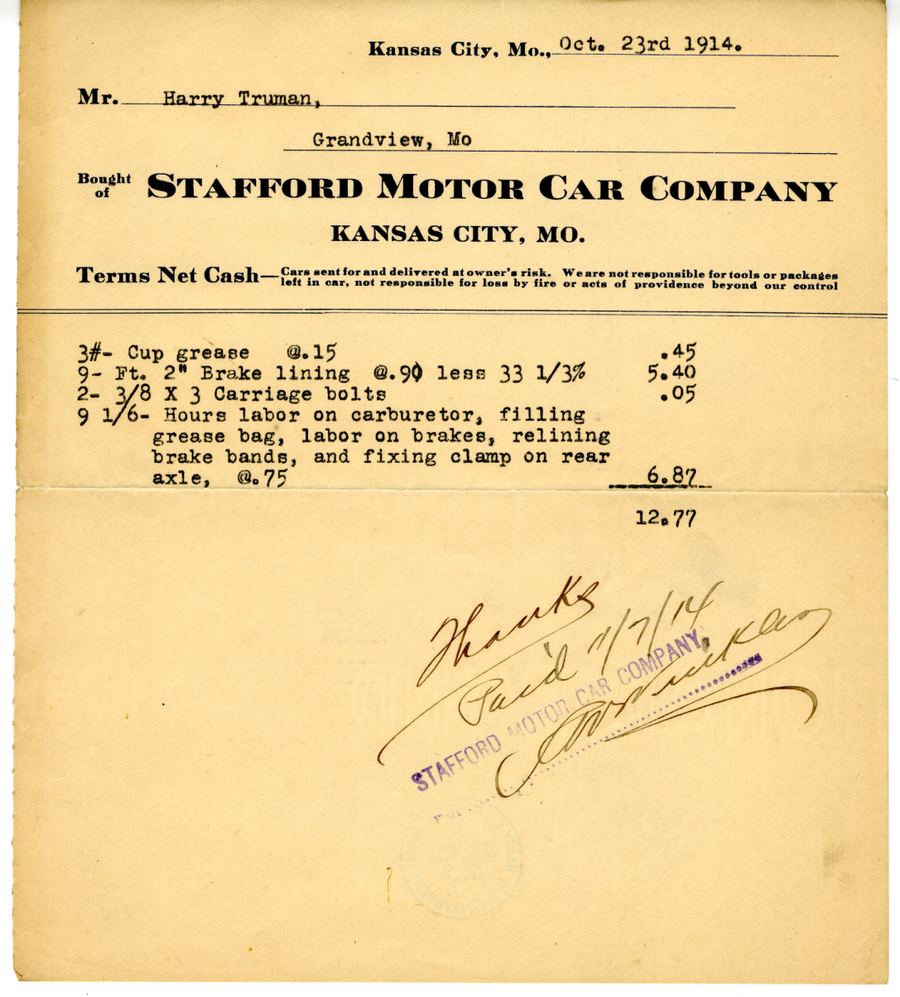
Parsevix renderuje każdą stronę i czyta ją przez OCR, nawet gdy PDF ma warstwę tekstową, więc odczytany zostaje też tekst w pieczątkach, zeskanowanych stronach i osadzonych obrazach. Język jest rozpoznawany na każdej stronie, a linie trafiają do ekstrakcji w kolejności czytania.
- 02
Tabele stają się listami
Wiersze tabeli wracają jako lista, jeden element na wiersz, także gdy tabela ciągnie się na następnej stronie.
- 03
Długie dokumenty za jednym razem
PDF do 30 stron jest czytany i przetwarzany jako jeden dokument, więc sumy i pozycje z różnych stron trafiają do jednego wyniku.
- 04
Wiele języków i pism
Między innymi pismo łacińskie, cyrylica, pismo greckie, arabskie, chińskie, japońskie i koreańskie; język jest rozpoznawany na każdej stronie.
- 05
Dane osobowe zamaskowane
Nazwiska, adresy i numery są maskowane automatycznie, zanim jakikolwiek tekst trafi do modelu AI, i wstawiane z powrotem do wyniku. Wykrywanie znajduje większość danych osobowych, ale niekoniecznie każdą z nich.
- 06
Każda wartość powiązana ze swoją stroną
Każda wartość jest powiązana z miejscem na stronie, z którego pochodzi. Kliknij ją w panelu, aby zobaczyć, gdzie była wydrukowana.
- 07
PDF-y ze skrzynki pocztowej
Przekazuj e-maile z załącznikami PDF na adres projektu, a każdy załącznik staje się dokumentem.
Jak trafiają PDF-y
Prześlij je, przekaż albo wyślij z własnego systemu.
Panel
Przeciągnij PDF-y do panelu, pojedynczo lub wiele naraz. Sprawdź każdy wynik obok jego stron i zatwierdź go.
Adres e-mail
Plany płatneKażdy projekt ma własny adres. Przekazuj na niego PDF-y, a każdy załącznik staje się dokumentem.
API
Wysyłaj PDF-y z własnego systemu i odbieraj JSON w tej samej odpowiedzi albo odbieraj wyniki podpisanym webhookiem lub przez Zapier.
Żądanie
curl https://parsevix.com/api/v1/extract-auto \
  -H "X-API-Key: $PARSEVIX_API_KEY" \
  -F file=@invoice.pdf
Żądanie pozostaje otwarte, dopóki dokument nie zostanie odczytany, i odpowiada JSON-em.
- POST /documentsPrzesyłanie bez czekania; wynik przychodzi webhookiem lub callbackiem.
- POST /extract-autoBez kategorii: każde pole, które Parsevix znajdzie, nazwane jak w dokumencie.
- POST /classifyTylko kategoria dokumentu, za 1 kredyt.
Odpowiedź · skrócona
Bezpieczeństwo i zgodność
- Dane osobowe maskowaneautomatycznie, przed etapem AI
- Szyfrowaniepodczas przesyłania i przechowywania
- Bez trenowania AIna Twoich dokumentach
- Pliki z API usuwanepo przetworzeniu
Płacisz za stronę, nie za funkcję.
Każdy plan czyta, sortuje i maskuje dokumenty tak samo. Wybór kategorii jest wliczony, a dokument, którego nie udało się przetworzyć, nic nie kosztuje.
Zobacz cennik- kredyt za stronę
- 1
- darmowych stron co miesiąc
- 20
- miesięcznie za 500 stron
- $39
FAQ o PDF do JSON
PDF do JSON:
odpowiedzi.
O to pytają ludzie, zanim przekonwertują pierwsze PDF-y.
Do 10 MB i 30 stron na plik. Dłuższy PDF trzeba podzielić na pliki, a każda część wraca jako osobny wynik.
Tak. Każda strona jest czytana jako obraz, więc skan bez warstwy tekstowej jest odczytywany tak samo jak PDF prosto z systemu księgowego.
PDF, który do otwarcia wymaga hasła, nie może zostać odczytany i kończy się jasnym błędem. Usuń hasło, a potem prześlij go ponownie.
Tak. Plik Word (DOCX) jest najpierw zamieniany na PDF, a potem czytany jak każdy inny PDF.
Jeden kredyt za stronę: dziesięciostronicowy PDF zużywa dziesięć. Wybór kategorii jest wliczony, a jeśli przetwarzanie dokumentu się nie powiedzie, kredyty wracają na konto.
PDF-y przesłane w panelu lub wysłane e-mailem zostają w projekcie, dopóki ich nie usuniesz. Pliki wysłane przez API są usuwane po przetworzeniu, chyba że włączysz ich przechowywanie dla projektu. Twoje dokumenty nigdy nie są używane do trenowania AI.
Powiązane zastosowania