
API OCR
Plik wchodzi. JSON wychodzi.
Wyślij PDF, plik Word albo obraz do jednego endpointu. Parsevix odczytuje każdą stronę przez OCR, maskuje dane osobowe i zwraca dane dokumentu jako JSON, w Twoich własnych polach albo nazwane etykietami samego dokumentu. Wypróbuj to na prawdziwych dokumentach w demo.
- Wbudowany OCR, także dla skanów i zdjęć
- Uporządkowany JSON, nie surowy tekst
- Synchronicznie albo przez webhook
Bez karty kredytowej · 20 darmowych stron co miesiąc
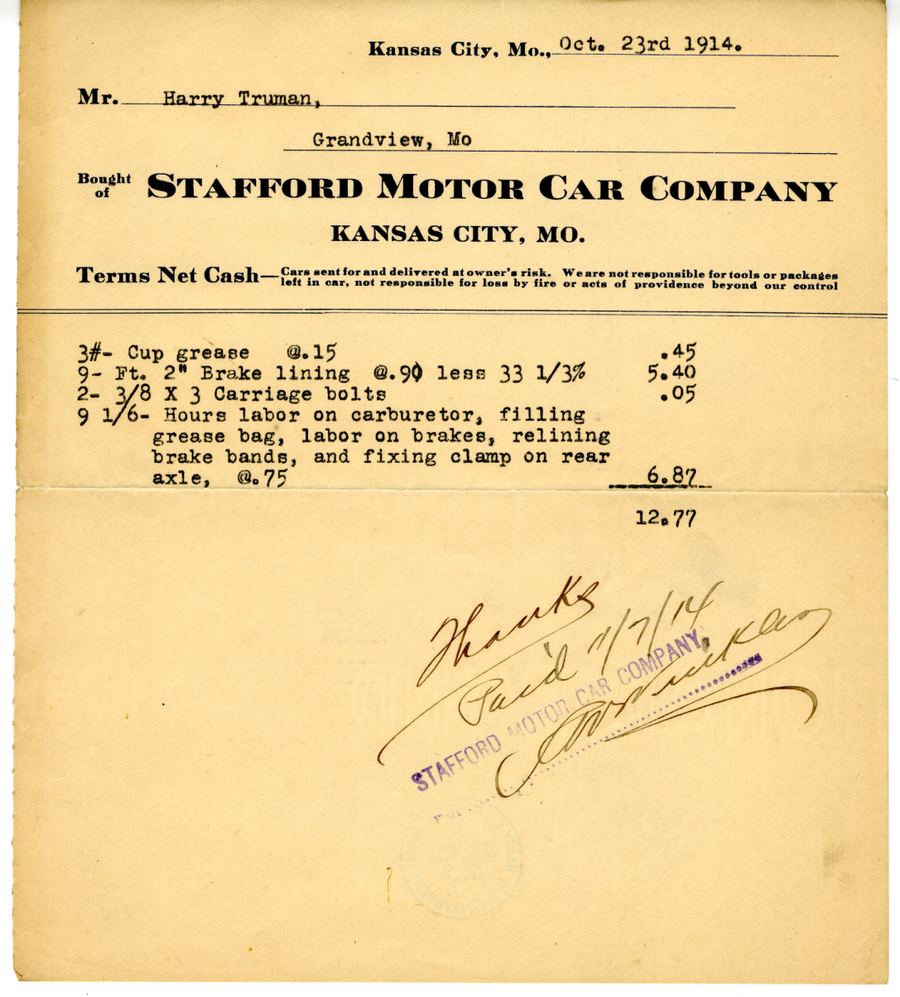
Nic nie jest przesyłane: demo odtwarza zapisany wynik.
Żądanie i odpowiedź
Jedno wywołanie, wszystko w odpowiedzi.
Panel
Najpierw wypróbuj dokumenty w panelu: każdy wynik jest pokazany obok jego strony, z każdą wartością zaznaczoną tam, gdzie została odczytana.
Adres e-mail
Plany płatneKażdy projekt ma własny adres. Dokumenty przekazane na niego są przetwarzane jak każde przesłanie, a ich wyniki mogą trafiać do Ciebie webhookiem.
API
Wyślij plik ze swoim kluczem API. Odpowiedź to JSON: pola dokumentu, jego język i liczba stron.
Żądanie
curl https://parsevix.com/api/v1/extract-auto \
  -H "X-API-Key: $PARSEVIX_API_KEY" \
  -F file=@invoice.pdf
Żądanie pozostaje otwarte, dopóki dokument nie zostanie odczytany, i odpowiada JSON-em.
- POST /documentsPrzesyłanie bez czekania; wynik przychodzi webhookiem lub callbackiem.
- POST /extract-autoBez kategorii: każde pole, które Parsevix znajdzie, nazwane jak w dokumencie.
- POST /classifyTylko kategoria dokumentu, za 1 kredyt.
Odpowiedź · skrócona
Dla programistów
OCR i ekstrakcja w jednym wywołaniu.
Jedno żądanie na dokument, jedna odpowiedź JSON. Oto, co daje API.
Wbudowany OCR
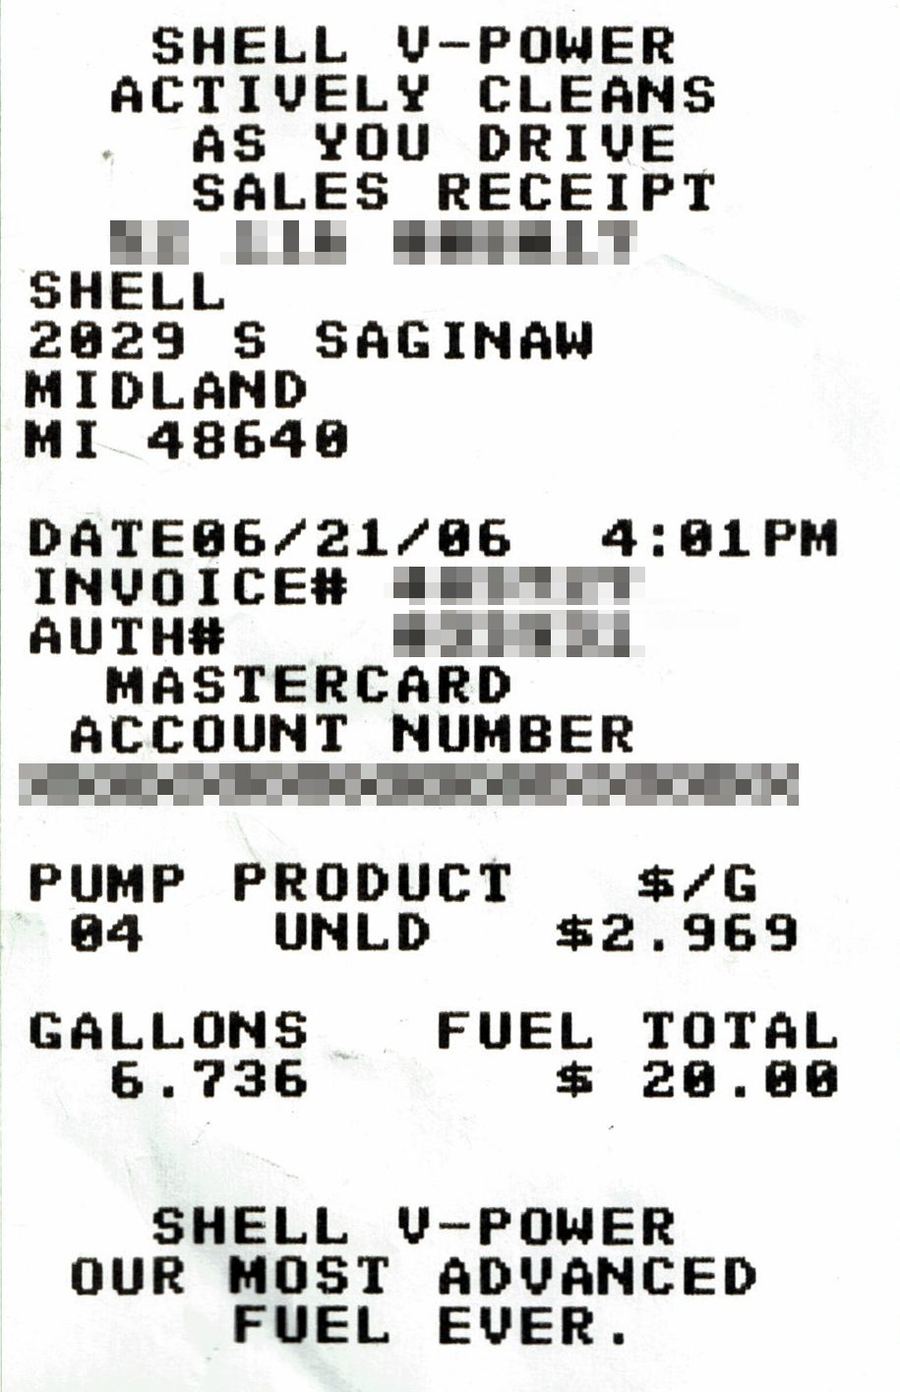
Nie potrzebujesz własnego silnika OCR. Parsevix renderuje każdą stronę i ją odczytuje, także skany i zdjęcia z telefonu, obraca strony leżące bokiem lub do góry nogami i rozpoznaje język na każdej stronie. Pola są wyciągane z odczytanego tekstu, a w odpowiedzi dostajesz JSON.
- 02
Jakie pisma odczytuje
Łacińskie, chińskie i japońskie, a dzięki osobnym modelom także cyrylicę, greckie, arabskie, koreańskie, dewanagari, tajskie, tamilskie i telugu. Hebrajskie, ormiańskie i gruzińskie nie są jeszcze odczytywane.
- 03
Domyślnie synchronicznie
POST /api/v1/extract czeka, aż dokument zostanie odczytany, i odpowiada wynikiem. Do 5 otwartych żądań na klucz i 30 stron na plik.
- 04
Albo asynchronicznie
POST /api/v1/documents odpowiada od razu; wynik przychodzi potem podpisanym webhookiem, na adres callback URL albo przez Zapier.
- 05
Limity według planu
Od 10 żądań na minutę na klucz w planie darmowym do 300 w planie Business. Każdy plan czyta dokumenty tak samo.
- 06
Jeden kształt błędu
Każdy błąd to { "error": { "code", "message" } } ze stałym kodem z kropkami, więc Twój kod odróżni wyczerpany limit od nieczytelnego pliku.
- 07
Pliki usuwane po przetworzeniu
Pliki wysłane przez API są usuwane, gdy tylko wynik zostanie wysłany, chyba że włączysz ich przechowywanie dla projektu.
Bezpieczeństwo i zgodność
- Dane osobowe maskowaneautomatycznie, przed etapem AI
- Szyfrowaniepodczas przesyłania i przechowywania
- Bez trenowania AIna Twoich dokumentach
- Pliki z API usuwanepo przetworzeniu
Płacisz za stronę, nie za funkcję.
Każdy plan czyta, sortuje i maskuje dokumenty tak samo. Wybór kategorii jest wliczony, a dokument, którego nie udało się przetworzyć, nic nie kosztuje.
Zobacz cennik- kredyt za stronę
- 1
- darmowych stron co miesiąc
- 20
- miesięcznie za 500 stron
- $39
FAQ o API OCR
API OCR:
odpowiedzi.
O to pytają programiści przed pierwszym żądaniem.
Nie. OCR jest częścią każdego żądania: Parsevix sam odczytuje strony i odpowiada danymi dokumentu w formacie JSON, za jeden kredyt na stronę. Nie ma osobnego endpointu na surowy tekst.
Dokumenty między innymi w piśmie łacińskim, cyrylicy, piśmie greckim, arabskim, chińskim, japońskim i koreańskim; język jest rozpoznawany na każdej stronie. Hebrajski, ormiański, gruziński, bengalski, gudżarati i pendżabski nie są jeszcze odczytywane.
Najlepiej działa tekst drukowany i pisany na komputerze. Pismo odręczne jest odczytywane tam, gdzie jest wyraźne; to, czego nie da się odczytać, zostaje puste zamiast być zgadywane.
Żądanie synchroniczne czeka do 285 sekund, co wystarcza na 30 stron. Dłuższe oczekiwanie kończy się przekroczeniem czasu; przy dużych partiach użyj asynchronicznego przesyłania z webhookiem.
API to zwykłe HTTP z przesyłaniem multipart i odpowiedziami w JSON; dokumentacja ma gotowe przykłady dla cURL, Python i Node.js, a Zapier łączy je bez kodu.
Pliki wysłane przez API są usuwane po przetworzeniu, chyba że włączysz ich przechowywanie dla projektu. Twoje dokumenty nigdy nie są używane do trenowania AI.
Powiązane zastosowania
Dokumenty, które idą w parze z tym.
Odczyt faktur
Sprzedawca, sumy, VAT i każda pozycja z faktur o dowolnym układzie.
Odczyt paragonów
Sklep, data, suma i podatek z paragonów papierowych i ze zdjęć.
Odczyt dokumentów tożsamości
Imię i nazwisko, numer, daty i obie linie MRZ z paszportów i dowodów osobistych.