
Da PDF a JSON
Entrano PDF. Esce JSON.
Carichi un PDF, digitale o scansionato, lo inoltri via e-mail o lo invii all’API. Parsevix legge ogni pagina e restituisce i dati come JSON, nei suoi campi o con i nomi delle etichette del documento stesso. Provi con i documenti reali della demo.
- PDF di testo e PDF scansionati allo stesso modo
- Fino a 30 pagine per file
- I suoi campi, o nessuno schema
Nessuna carta di credito · 20 pagine gratuite ogni mese
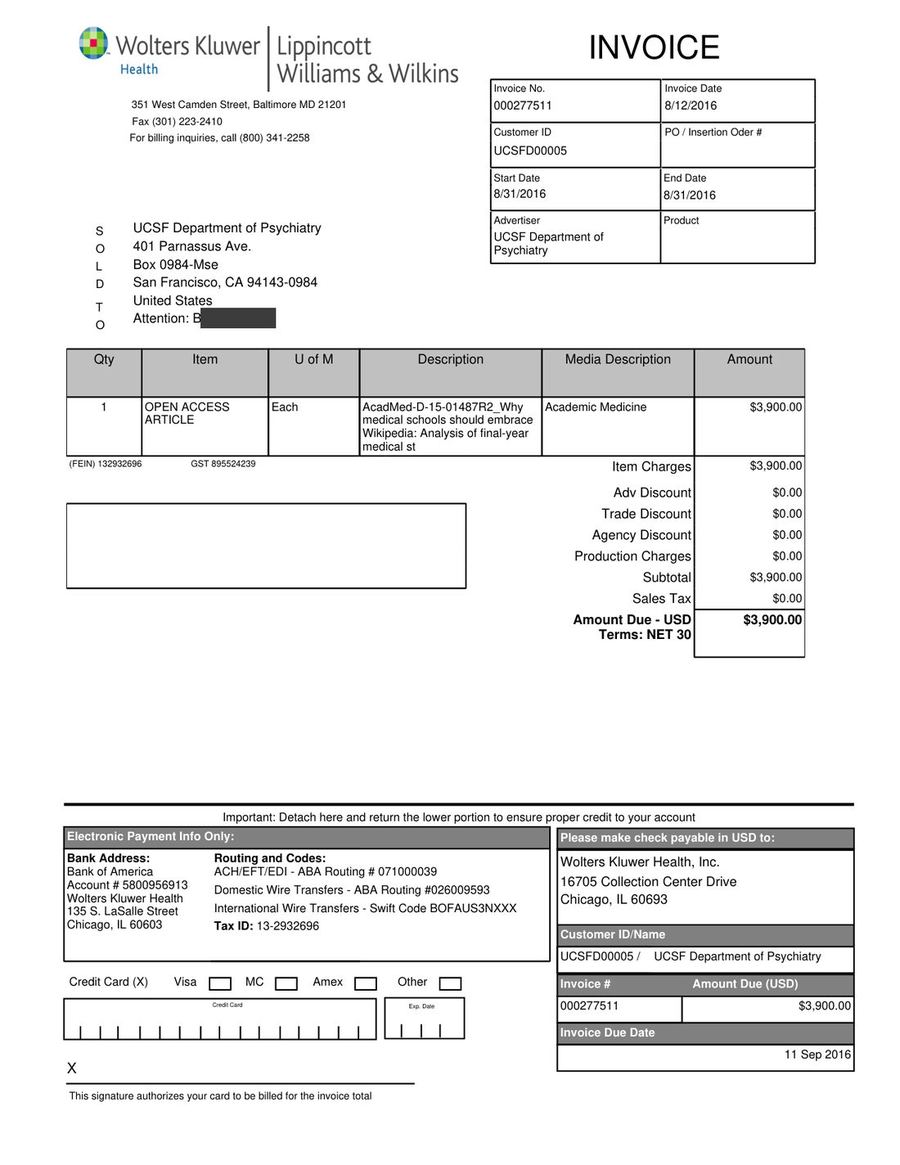
Abbiamo oscurato i nomi dei privati. Non viene caricato nulla: la demo riproduce il risultato salvato.
Due modi di dare forma al JSON
Il suo schema, o nessuno.
Lo stesso documento può tornare con i campi che ha definito Lei, oppure con i campi che contiene. Scelga per ogni caricamento, per ogni indirizzo e-mail o per ogni chiamata API.
Con una categoria
Indichi una volta i campi che le servono, oppure parta da una categoria integrata come Invoice o Contract. Ogni documento di quel tipo torna nella stessa forma, con date ISO e numeri semplici.
- invoice_number
- invoice_date
- seller_info
- line_items
- total_due
- currency
Categorie integrate per fatture, scontrini, contratti, documenti d’identità e altro; le sue per tutto il resto.
Senza schema
Invii il documento senza categoria e ottenga ogni campo che Parsevix trova, con i nomi delle etichette del documento stesso e nella sua lingua, con i valori così come sono stampati. La demo qui sopra funziona così.
L’inizio del risultato dello scontrino del negozio di scarpe, così come è tornato.
Come viene letto un PDF
Ogni pagina, ogni riga.
I PDF arrivano da gestionali contabili, scanner e allegati e-mail, con e senza livello di testo. Parsevix li tratta tutti allo stesso modo.
Ogni pagina letta come immagine
Parsevix converte ogni pagina in immagine e la legge con l’OCR, anche quando il PDF ha un livello di testo, così viene letto anche il testo di timbri, pagine scansionate e immagini incorporate. La lingua viene rilevata su ogni pagina e le righe passano all’estrazione nell’ordine di lettura.
- 02
Le tabelle diventano elenchi
Le righe di una tabella tornano come elenco, una voce per riga, anche quando la tabella continua alla pagina successiva.
- 03
Documenti lunghi in un colpo solo
Un PDF fino a 30 pagine viene letto ed estratto come un unico documento, così totali e voci di pagine diverse finiscono in un solo risultato.
- 04
Molte lingue e scritture
Scrittura latina, cirillica, greca, araba, cinese, giapponese e coreana, tra le altre; la lingua viene rilevata su ogni pagina.
- 05
Dati personali mascherati
Nomi, indirizzi e numeri vengono mascherati automaticamente prima che qualsiasi testo vada al modello di IA e rimessi nel suo risultato. Il rilevamento trova la maggior parte dei dati personali, ma non necessariamente tutti.
- 06
Ogni valore collegato alla sua pagina
Ogni valore è collegato al punto della pagina da cui proviene. Facendo clic nella dashboard vede dove era stampato.
- 07
PDF dalla sua casella
Inoltri le e-mail con PDF allegati all’indirizzo del suo progetto: ogni allegato diventa un documento.
Come arrivano i PDF
Li carichi, li inoltri o li invii dal suo sistema.
Dashboard
Trascini i PDF nella dashboard, uno alla volta o molti insieme. Controlli ogni risultato accanto alle sue pagine e lo approvi.
Indirizzo e-mail
Piani a pagamentoOgni progetto ha il suo indirizzo. Vi inoltri i PDF: ogni allegato diventa un documento.
API
Invii i PDF dal suo sistema e riceva il JSON nella stessa risposta, oppure riceva i risultati via webhook firmato o tramite Zapier.
Richiesta
curl https://parsevix.com/api/v1/extract-auto \
  -H "X-API-Key: $PARSEVIX_API_KEY" \
  -F file=@invoice.pdf
La richiesta resta aperta finché il documento non è stato letto e risponde con il JSON.
- POST /documentsCaricare senza attendere; il risultato arriva via webhook o callback.
- POST /extract-autoSenza categoria: ogni campo che Parsevix trova, chiamato come nel documento.
- POST /classifySolo la categoria del documento, per 1 credito.
Risposta · ridotta
Sicurezza e conformità
- Dati personali mascheratiautomaticamente, prima del passaggio all'IA
- Crittografiain transito e a riposo
- Nessun addestramento dell'IAsui suoi documenti
- File API eliminatidopo l'elaborazione
Si paga per pagina, non per funzionalità.
Ogni piano legge, classifica e maschera i documenti allo stesso modo. La scelta della categoria è inclusa e un documento non riuscito non costa nulla.
Vedi i prezzi- credito per pagina
- 1
- pagine gratuite ogni mese
- 20
- al mese per 500 pagine
- $39
FAQ da PDF a JSON
PDF in JSON,
le risposte.
Cosa si chiede prima di convertire i primi PDF.
Ha ancora una domanda?
Ci scriva. Ogni messaggio viene letto da una persona.
Fino a 10 MB e 30 pagine per file. Un PDF più lungo va diviso in più file, e ogni parte torna come risultato a sé.
Sì. Ogni pagina viene letta come immagine, quindi una scansione senza livello di testo viene letta come un PDF uscito direttamente da un gestionale contabile.
Un PDF che richiede una password per essere aperto non può essere letto e non riesce con un errore chiaro. Rimuova la password, poi lo carichi di nuovo.
Sì. Un file Word (DOCX) viene prima convertito in PDF e poi letto come qualsiasi altro PDF.
Un credito per pagina: un PDF di dieci pagine ne usa dieci. La scelta della categoria è inclusa e, se un documento non riesce, i suoi crediti le vengono restituiti.
I PDF caricati nella dashboard o inviati via e-mail restano nel suo progetto finché non li elimina. I file inviati tramite API vengono eliminati dopo l’elaborazione, a meno che non ne attivi la conservazione per il progetto. I suoi documenti non vengono mai usati per addestrare l’IA.
Casi d’uso correlati
Documenti che viaggiano insieme a questo.
Estrazione dati fatture
Fornitore, totali, IVA e ogni voce da fatture di qualsiasi layout.
Estrazione dati dai contratti
Parti, date, valore e clausole principali di un contratto.
Conversione estratti conto
Conto, saldi e ogni movimento da estratti conto in PDF.